
先别看教程目录。先打开你上一次垫图失败的那张。
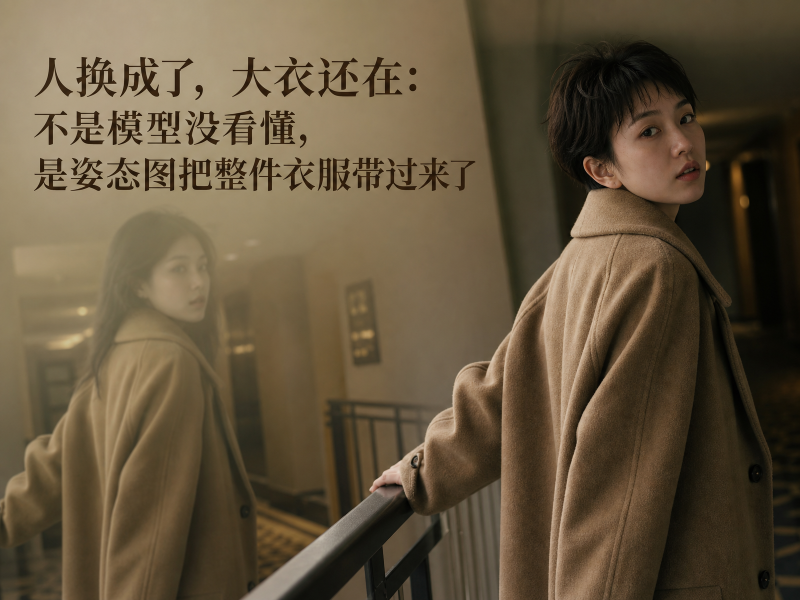
人也许换对了。店也许换对了。可你总觉得哪里不对:衣服串了味,墙上多出一块原图里的牌子,回头变成了证件照式微笑,镜头自己抬到了眼睛高度。
这时你最容易做两件事。换模型。或者把提示词再写长一截。
两件都先别做。
模型不是没看见你的参考图。它看见得太全了。你只想借一张图里的站法和机位,它把大衣纹理、廊灯、大理石反光、远处那块指示牌,全当成可以抄的东西。文字写得越勤快,越是在跟一张信息过载的照片打架。
这篇只做一件事:把「怎么站、从哪拍」从原图里单独抠出来,再拿去跟「是谁」「在哪」会合。图片和视频是同一套手势。你会在自己的手机相册上把两遍都跑完。
今晚只用相册里这三张
不要虚构客户,不要另开一个项目。就用你现在就能找到的东西。
图1:站法来源。 一张你并不是想「长成这样」的图。比如地铁柱子旁有人侧身回头,人偏画面右边,镜头略低,右手搭在柱子上。你喜欢的是这个回头,不是他的冲锋衣,也不是站台广告灯箱。
图2:你要换成的人。 一张清楚的半身或全身。脸、发型、衣服以这张为准。不要用美颜拉满的证件照也没关系,但不要和站法图是同一个人。
图3:你要换成的地方。 你家阳台、便利店夜班过道、工作室一角,都行。有前后层次最好:近处有栏杆或货架,远处有窗或灯。
视频稍后用同一组人和地。先把静帧做明白。静帧都不听你的,视频只会把错误拉长。
把三张图并排放在桌面上。生成之前,先用嘴说一句:
图1只许管站法和镜头。图2只许管是谁。图3只许管在哪。
说不出来,就还没准备好点按钮。
模型看见的,比你看见的多
你看图1,脑子会自动忽略。你看见:人在右边,镜头偏低,右手搭着,在回头。
模型没有忽略。它看见冲锋衣的面料、站台黄线、灯箱广告、柱子上的污渍、那个人的耳钉、天花板灯管。对它来说,这些都是特征。特征就能被抄。
所以你会看见四种很典型的废图,常常叠在一起:
- 动作有点像,人却穿着图1里那件冲锋衣
- 人换成了,回头变成正面微笑,因为图2的朝向在抢
- 地换成了,地铁灯箱却印到了你家墙上
- 人按低机位站,房间却按平视拍,脚悬空
不是「融合自然」四个字能压住的。照片每出现一次衣服,就跟「换成图2的衣服」打一次架。灯箱每出现一次,就跟「换成图3的墙」打一次架。
加第四张参考解决不了。要把图1里不该上班的东西先清走,只留下空间:谁近,谁远,谁挡住谁,人有多大,镜头在哪。
行业叫法是深度图。你不必先记名字。先把它看成一张空间底片。
它长得很丑。近处亮,远处暗。没有颜色,没有花纹,没有广告字。同一距离上的脸、衣服、头发,会是差不多的灰。它不负责好看。它只负责告诉后面的模型:东西在空间里怎么摆。
有的工具黑白是反的,近处反而更黑。用之前看一眼,不要猜。猜错等于前排后排对调,人会贴到墙上,栏杆会砸到镜头前。
三种灰,只有一种能用
新手最容易在这里浪费一晚上。因为三种图看起来都是灰的。
第一种:去色。 你把图1丢进调色,饱和度拉到零。冲锋衣还在,只是变成深灰冲锋衣。灯箱还在。黄线还在。去色只拿走颜色,明暗仍是衣服和灯光的明暗,不是远近。白衣服会很亮,不代表它离镜头近。黑头发会很暗,不代表它在远处。
第二种:灰色立体人。 你让模型「生成一个灰色的立体人物」。出来像游戏里没贴图的角色,脸上还有光。姿势往往已经被改过,镜头也变了。那是三维软件里检查造型的预览,不是每个点在记录距离。
第三种:空间底片。 人还是那个轮廓,世界只剩下前、中、后。右手如果比身子更近,会更亮。柱子后面的通道沉成深灰。没有面料,没有字,没有耳钉反光。同一块连续表面,灰是慢慢过渡的。
把这三张并排。能一眼分出来,再往下做。分不出来,后面的提示词再漂亮也是在给一张假底片打工。
为什么一张普通照片能估出第三种?模型靠透视、遮挡、近大远小去猜谁更近、谁更远。它不知道她离镜头一米五还是两米。所以这张底片适合管创作,不适合当尺子。身份、布料、光线气氛,它本来就带不走。这不是缺陷。这正是你要它的原因:把爱抢权的那些东西,先清掉。
不是每张喜欢的图都该抽底片
抽之前问一句。你真正想留下的是哪一层。
想留胶片金、窗格子投影、面料质感——用原图或风格参考。抽完,你要的东西正好没了。
想留关节怎么折,场景和镜头都可以换——姿态骨架更直接。底片只能给个大概,手指仍会糊。
只想要利落的人影边缘——线稿或边缘图更灵活。
要人站右边、镜头低、右手搭着、货架在后——这才是空间底片的活。
要人从冷柜走到收银台、镜头跟着往后撤——做成空间底片视频。它抄得动走位和推拉,抄不动捏瓶盖、交叉握手。那些距离太近,又互相挡,底片上会糊成一团灰。
你今晚这三张,如果图1让你心动的是站法和机位,就抽。如果让你心动的是冲锋衣和地铁灯,就别抽。抽错层,后面会怪模型,其实是你把要的东西先扔掉了。
静帧对照:同样三张图,先看它怎么死
素材不许换。只换顺序。
第一遍,故意做死
三张一起丢进去。写严一点也没关系。你要亲眼看见:写严压不住权限冲突。
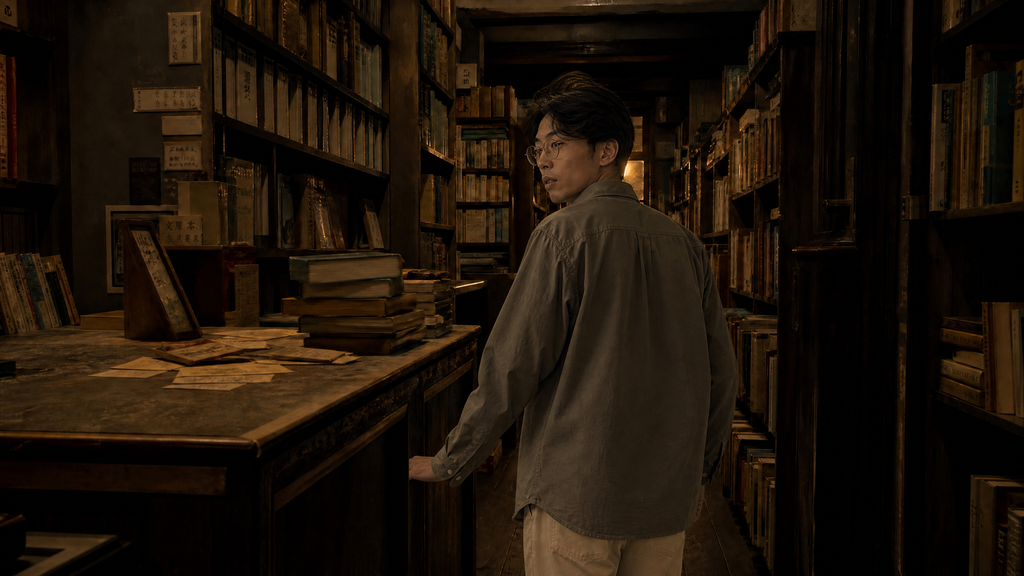
出来以后不要马上改词。先给废图做标记:串了哪件衣服,搬来了哪块牌子,镜头抬了没有,脚悬空没有。这张废图留下。第二遍要对着它看,你才知道到底治了什么。
形容词救不了这一遍。「高级感」「电影感」「融合自然」只会把人往画面中间推,让它更像海报。
第二遍,先做底片,再会合
先看图1。 不要看衣服。问自己四句:人占画面哪一块、有多大;镜头偏低还是平视;哪只手在前;近处有没有东西挡在人和镜头之间。四句答不全,先别转。你自己都没决定抄什么,模型只能猜。
再转底片。 即梦、通义,或任何能看图的模型都行。句子里必须是「转换原图」,不能是「生成一张灰色人物」。后者它会重新摆姿势。
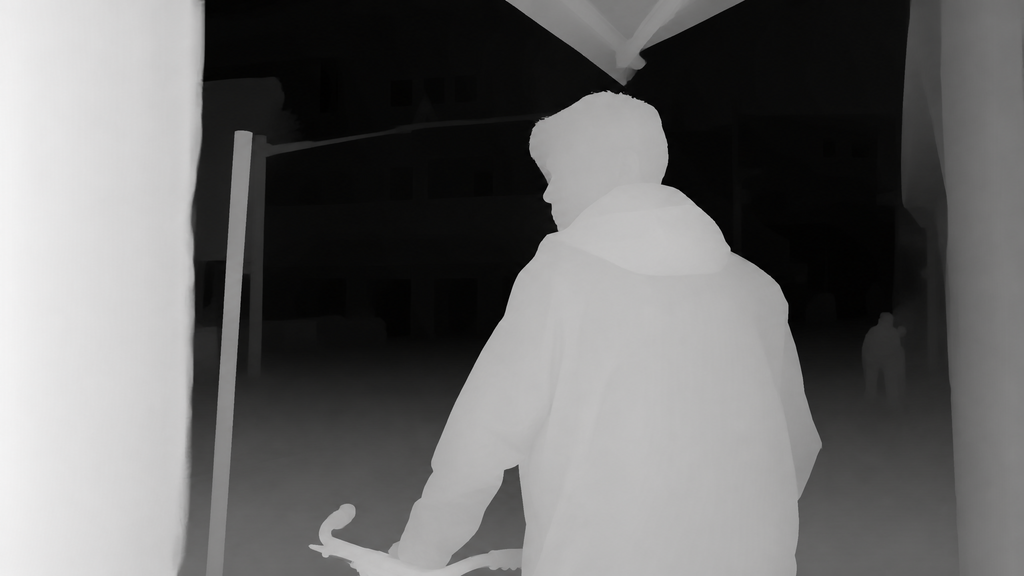
转完停三十秒。不合格就重转,不要带着一张脏底片去合图。合图翻车时,你会误以为是后面那句提示词不行。
看这五处:
- 人还在原来那一块,没有被放大成居中海报。
- 姿势还是回头、手还在柱子上,没有变成正面站。
- 近处亮、远处暗;如果白衣服特别亮、黑头发特别暗,说明它还在抄明暗,不是远近。
- 冲锋衣纹理、灯箱文字都没有了。还能认出广告,就重转。
- 手和柱子是分开的,不是一团白。
脏的那张往往还能看见扣子和字。那不是底片,是一张灰色的地铁照片。把「禁止保留材质和花纹」再说一遍,再转一次。
然后三张会合。 上传顺序写死,避免它对错图:
- 你要换成的人
- 你要换成的地方
- 空间底片
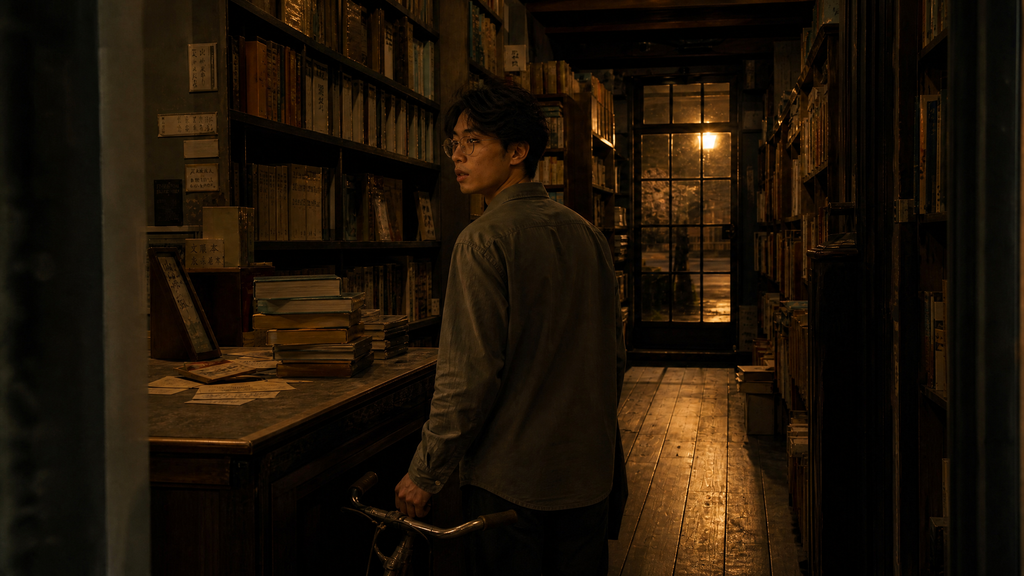
对照第一遍那张废图。人应该还是图2的人,地方还是图3的地方,回头和低机位还在,地铁灯箱应该没了。衣服上的纹路应该来自你自己那件,不是冲锋衣。
如果还不稳,先查三处,再考虑换模型:底片五条验收过了没有;三张图顺序乱了没有;提示词里又写回「电影感」没有。
静帧通了,再做视频。视频只是把同一只手势拉长。
视频对照:抄走法和退镜,不要抄原片那个人
去找一条十几秒的参考视频。不要找剪辑花活。找这种:一个人从深处走到近处,或从冷柜走到柜台,镜头慢慢往后撤,前景有货架或栏杆从画面边上刮过。
你要的是走法和退镜。不是原片那个人,也不是原片那家店。
第一遍你大概会这样:原片、你的人物图、你的环境图,一起丢进视频模型,写「动作保持,运镜一样」。
出来常见的是:你穿着原片的衣服,你家的墙变成原片的玻璃门,退镜变成推进脸。更糟的时候人在原地转圈。因为原片里的衣服、灯光、店面布局全在上班,动作和运镜被挤到边上。
所以原片先变成空间底片视频。每一帧都是远近,不要去色。去色之后围裙还在闪,玻璃还在反光。你要留下的是:人怎么移动,镜头怎么撤,前景什么时候刮过。
整段的亮暗标准必须统一。这一秒把人拉得很白,下一秒又压黑,看起来像更清楚,模型看起来像人物在闪。后面再让它抄动作,动作会跟着闪。
用能处理视频的助手或工具时,把这段当工单。原文件只读。
按大约 15 秒拆,是因为多数视频模型一段就吃这么多。硬塞二十秒,不如两段接。接的时候人物图、环境图、远近方向保持同一套,不要让第二段重新决定这盏灯有多亮。
转完先播,只看三件事:人还在走那条路,没有瞬移;镜头仍在后退,没有改成推脸;灰不闪,前景刮过时是慢慢变大。有一件不对,不要合成。合成救不了坏底片。
合成时上传顺序同样写死:
- 你的人物图
- 你的环境图
- 空间底片视频
两段 15 秒再接。人应该还是你要的那个人,地还是你要的那个地,退镜还在,前景还会刮过。原片的衣服和玻璃门应该没了。
看到这里你会发现,图片和视频没有两套理论。都是先把空间里怎么摆、怎么动,单独做成底片,再让身份和场地认领自己的部分。
底片交不出的,不要回头去加强它
成片看起来对了,你还会不满意两件事。两件事都对。两件事都不该靠「把底片做清楚一点」解决。
脸太平。 底片上,脸经常只是一块灰。微笑、皱眉、眨眼、嘴张开一点、眼睛看向左侧,几乎不造成远近差。它知道脸在这儿、头往这边转。它不知道嘴角动不动。
回去改底片,脸还是一块灰。把脸写在合图或视频提示词里。写部位,不写评价。
不要写:表情自然,微微微笑,高级感。
写:
走路时要「有一点笑」,也写在动作之外。不要指望底片视频把笑带过来。带不过来。
手不对。 手指距离近,又互相挡。转到底片上,五指容易粘成一只白手套,甚至少一根。扣杯沿、捏瓶盖、按门铃,靠的是指节怎么折、指腹触哪一块,不是「手在身前还是身后」。
大动作继续交给底片:回头、走步、退镜。接触点另外写,写接触,不写漂亮。
还不行,就不要在这一段里赌手部特写。中景先把走位和退镜做稳。手另出近景。别让底片去干它交不出的活。
分界其实很清楚:
- 人在哪、有多大、谁挡谁、镜头高低、大幅度走位、推拉摇移:交给空间底片
- 表情、眼神、口型、手指、很近的道具接触:另外写字
- 是谁、穿什么、这个地方什么颜色、光从哪来:交给人物图和环境图
越过一次,模型就重新开始猜。看起来像有时灵、有时不灵。其实是同一张图上了两个班。
你现在就可以关文,去跑对照
不要收藏这篇文章。打开相册里那三张。
第一遍直接三图合,把废图留下。 第二遍先转空间底片,验收过了再合。 视频先转底片序列,不闪了再合成。 笑和手指最后写,不要回头去「加强」那张灰图。
两遍贴在一起看。你要看见的不是模型突然变聪明,而是图1终于不再把整件大衣和整面灯箱一起带过来。
你要的从来不是那件大衣。你要的是她怎么站,镜头在哪。
暂无评论内容