
你把图丢过来的时候,提示词大概是这样的:
拉面店里一个短发女生,五官精致,皮肤细腻,眼神自然,
缓慢转头,轻轻微笑,动作流畅,自然生动,电影感
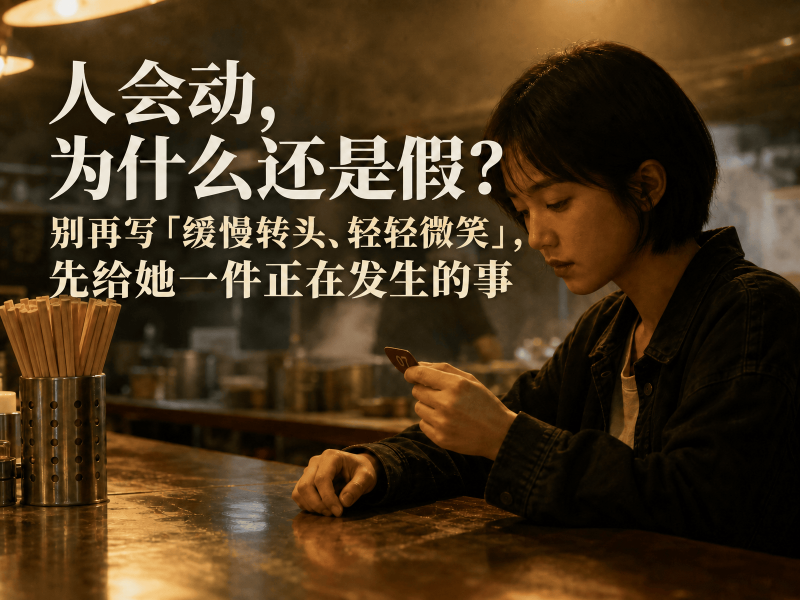
图并不差。吧台在,热气在,人的脸也清楚。可你多看两秒还是想划走。她不是不会动,是动得太懂事了:你写转头,头就标准地转;你写微笑,嘴角就标准地抬。像在交一张名叫「动态」的试卷。手里的号码牌是道具。热气是贴上去的。她不在等面,她在等你夸她像真人。
你后补的两句我也看见了。「再自然一点。」「微动作细腻一点,不要假。」脸更会动了,人还是假人。最多变成:一个在标准地眨眼,一个在标准地转头。还是表演。只是表演得更会。
带声音的模型还有两个坑:你不写「无台词」,她会开口报菜名;你不写「无背景音乐」,店里会突然响起一首歌。人立刻更假。
【二十八】练过别给脸派任务。【四十九】练过别把开心生气贴脸上。【二十七】练过别把动作写成待办。【三十六】练过两个人别抢同一秒。 这一节接在后面:脸对了,情绪也不贴了,人还是假,是因为这八秒里她没事可干。她只是被你安排着动。
口诀:人像不像真人,不看脸清不清。先给她一件正在发生的事,再让这件事把身体带过去。没有这件事,转头、微笑、眨眼,全是体操。
先把验收说清楚。你要的不是「看得出她在动」,是:
她坐在吧台前等面。号码还没叫到。厨房里忽然漏过一声。她低头看了一眼手里的号码牌,手指捏紧,这才抬眼看向后厨。面还在锅里。她不看镜头。店里不要自己配歌。
下面只用这一家店跑完。夜里十点四十。城中村巷口,还没打烊的拉面店。人、吧台、热气、号码牌、不锈钢筷子筒,全部不许换。
提示词都能直接贴。先出静帧当首帧,再跑图生视频。先看她这八秒有没有被一件具体的事打断,别先问清不清、像不像电影。
开场:你写的是动作清单,它当成广播体操去演
「缓慢转头、轻轻微笑、动作流畅、自然生动」对你是感觉。对它是四张可以随便贴的动作贴纸。它最省事的做法,就是找训练里最常见的那种「好看的店里坐着的人」:人居中、头标准地转、嘴角刚好抬到广告会用的那个弧度。于是你看见的是清楚,不是这个人。
真人在拉面店里等面的时候,身上同时装着好几样东西:刚才报过号、现在还没轮到、下一秒可能要被漏掉。手上也闲不住。后厨一直在出声。模型不会自动替你装。你只报自然生动,它就交一份标准「店里坐着的活人」作业。
所以正确的顺序不是「先写她长什么样,再让她动」。是先让这八秒里发生一件能打断她的事,再允许身体跟着那件事走。
看图时只问两句:她这会儿正在等什么?忽然发生了哪一下,才让她不得不动?
一、别写「让她动起来」,写这八秒里发生了哪一件事
很多人以为人物假,是因为动态不够。于是开始加:转头、抬眼、微笑、头发飘、衣角动。画面不会崩。它只是假。假在没有中间那一层:她为什么非动不可。
图片只要一瞬间好看就够了。视频要在八秒里持续像真人。真人不会像雕塑,但真人更不会无缘无故做广播体操。等车会看手机,不是因为「看手机很自然」;是因为车还没来,手要找事干。你把「找事干」写成「动作流畅」,模型就交模板。
1. 你问「她怎么动」,它只会给你一套标准动作
你原来那句,属于只报体操:
拉面店短发女生坐在吧台前,手里拿着号码牌,缓慢看向镜头,动作自然常见结果:人坐得端正,号码牌像道具,头按节拍转向镜头,眼神发光。店在。人在。热气也在。她不在等面。
交作业的标志就三样:全是「缓慢、轻轻、自然」;没有「被什么打断」;没有「动完之后还停在哪」。看见这三样,这段词可以直接删。不是它写得不够好,是它答错了题。
这一步只练一件事:先判断这段词里有没有一件正在发生的事。没有,等于她只是在动。
2. 同一张图,把「表演看镜头」改成「被漏号打断」
先出静帧。长相、店、灯,交给这张图。
文生图(首帧):
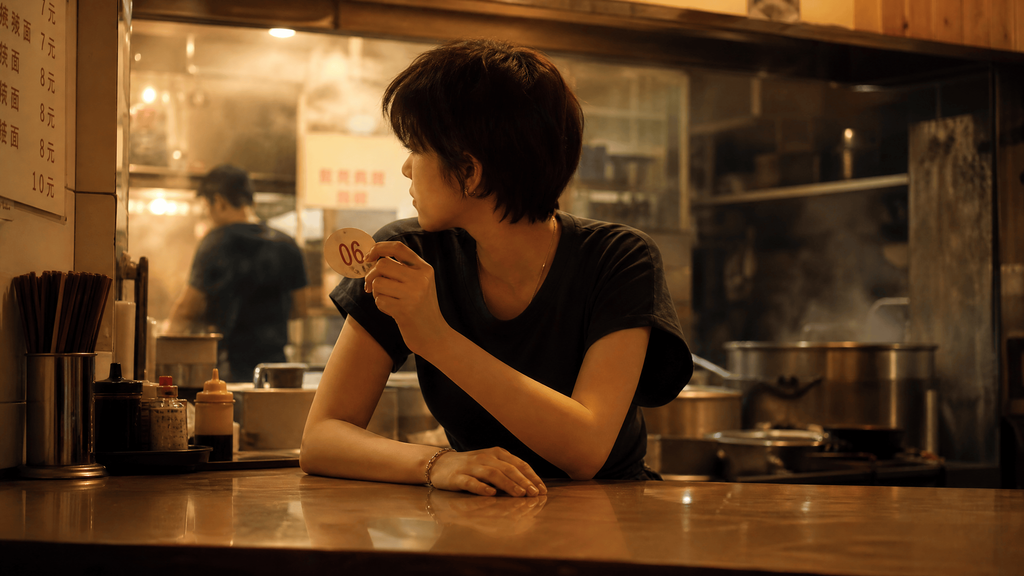
图过了,再跑图生视频。视频里不要再介绍她是谁、店在哪。
错的视频词(只写怎么动):
生成单镜头。固定镜头。无台词。无背景音乐。
她手里拿着号码牌,缓慢看向镜头,衣角轻轻动。读完你能在店里把她摆回去:她不是在拍广告,她是在核对「是不是漏了自己」。摆不回去的,还是体操。
| 你以为写细了 | 模型实际在猜 | 常见样子 |
|---|---|---|
| 拿着号码牌看镜头 | 为什么看、看谁 | 标准地转向镜头,眼神发光 |
| 动作自然、微微动 | 被什么打断 | 头、手、头发同时开始演 |
| 店里很有生活感 | 她此刻在等什么 | 碗已经在桌上,她还在「等人」 |
改法先记一句:身份、店名只当介绍。真正占位置的,是这八秒里那件打断她的事。
二、别写动作表面,先问这个动作被什么打断
很多人会直接描述动作:
女生抬头。
女生回头。
女生搅筷子。
女生慢慢坐着。
头发随热气飘。
这些写法都没有错,但它们只是动作表面。如果动作没有原因,视频就容易变成摆拍。
1. 她会动,不等于她有事
再看吧台上同一个人。静态图已经很好看:人在,筷子筒在,热气在。如果做成视频,只写:
生成单镜头。固定镜头。无台词。无背景音乐。
她坐在吧台前,轻轻搅动筷子,缓慢微笑,镜头不要动。
这段不是没有动态。筷子会动,人会笑。但问题是:她为什么搅?为什么笑?面还没上来,搅什么?厨房里有没有叫她?如果没有原因,动作就只是表演。
AI 视频真正要写的,不只是「她做了什么动作」,而是这个动作为什么发生。
2. 给一个能听见的触发
改成:
这样写,人物就不是单纯「拿着筷子坐着」,而是有了一个明确处境:她在等叫号。 所以她会停手,会抬头,表情也会从走神变成核对。
同样是「手里有筷子」,普通写法只是让人物动起来;更好的写法,是让人物因为听到声音、发现不对、要确认一件事而自然动起来。
写的时候多问一句:这个动作是被什么事情触发的?
- 转筷子,是因为还在等,手要找事干
- 停住,是因为听到叫号
- 抬眼,是因为要核对是不是自己
- 表情变化,是因为走神被打断
当动作有了这件事,角色就不再像在摆姿势,而像正在经历一个瞬间。
想贴标签的时候,改成眼睛能核对的那一下。一次只改一处:
| 你想写 | 改成能看见的 |
|---|---|
| 动作自然、生活流 | 手还在转筷子;叫号后才停 |
| 轻轻微笑、表情自然 | 不笑;抬眼只为核对号码 |
| 微微动、不要假 | 旧动作先停住;新动作才发生 |
写完问自己:旁边拍的人听完,能说出「她刚才被什么打断了」吗?说不出的,生成出来多半还是体操。
三、别只写一个动作,把八秒填成能跑的过程
四问都问了,有人会把答案揉成一个词:低头、出神、发呆。这样写出来的人物,往往还是像在摆拍。因为它只写了结果,没有写过程。
8 秒不要装下进门、点餐、吃面、结账。只装得下:她本来在等,被一件事打断,身体走完这一下。
更好的方法是,把提示词拆成一个完整过程。单人可以按这个填,不必一次写满七个形容词:
她是谁(一句就够)→ 坐在哪 → 这会儿正在干什么 → 被什么打断 → 身体连续怎么变 → 漏出哪一下控制不住的反应 → 镜头动不动
身份只当介绍。真正占位置的是后面六格。
我们就用吧台这张图。她独自坐着,身体微微前倾,眼神下垂,面前没有碗。这个画面很适合做成「人正在走神,然后被店里的一声响拽回来」。
如果只写:
女生坐在拉面店里低头沉思,镜头缓慢推进,电影感这段虽然有画面,但还是太空。人物为什么沉思?她是刚看完号码,还是在等面等到走神?低头之后,有没有细微反应?这些都没有交代。
按照格子拆开:
| 格子 | 这张图怎么填 |
|---|---|
| 人 | 短发女生(首帧里已经有了,视频里可删) |
| 坐在哪 | 夜里拉面店吧台,暖黄灯,后厨有热气 |
| 正在干什么 | 等面,低头出神,右手搭在台边 |
| 被什么打断 | 后厨碰了一下不锈钢盆 |
| 身体怎么变 | 先低头发呆 → 手指在台面上收紧 → 目光缓慢移向后厨 |
| 漏出哪一下 | 缓慢眨眼,呼吸带起肩膀,神情还是克制 |
| 镜头 | 固定镜头。不要推。不要绕 |
组合成完整视频词,可以写成:
这样写的好处是,人物不是只有一个「低头」的动作,而是有完整的变化过程:
先出神, 再停顿, 再缓慢看向声源, 最后带出「我还在等」这件事。
这就是单人视频最重要的地方:不要只写一个动作,要写出人物当下的状态、动作变化和细微反应。
还空,是三截写成了同一种「她在坐着」。 又在演戏,是中途加了回头、掏手机、对镜头笑。 店变形、乱切镜,是「生成单镜头、固定镜头」没写死。
只写「低头沉思」,等于把终点叠在同一秒。模型不知道第 1 秒和第 8 秒有什么区别,于是全程都在表演终点:人一出场,就已经是「沉思」表情包。
再加「端起碗、吸一口、满意点头」,又会变成待办事项。那是下一条的事。
- 还在等: 低头、空手、面没来
- 桥: 被一声响打断,手收紧
- 才看过去: 目光移向后厨,碗还没上来
四、大动作写不进去的时候,靠身体自己漏出来的零件
不是所有画面都适合转头、起身、挥手。有的人这八秒必须坐住:在等人,在听号,在假装自己不着急。这种时候你若硬写大动作,人会假得更明显——她忽然开始演戏。
庄重的宫殿如此。深夜吧台也是。她不能大动,不等于她是雕塑。
如果只写:
生成单镜头。固定镜头。无台词。无背景音乐。
她坐在吧台前缓慢转头,头发轻飘,电影感。这段虽然有动态,但还是容易假。因为人物只是按照提示词在动,并没有真实的身体反应。她不需要大动作,反而要靠很轻的、自己控制不住的零件来变真实。
比如:
这段动作并不多,但会更像真人。
因为真实的人即使坐着不动,也不会完全静止。她会有呼吸,会有眼神停顿,会有手指细微用力,也会因为「还没轮到我」而出现很轻的表情反应。
这一节要强调的是:视频里的真实感,不一定来自大动作,而是来自小反应。
尤其是等、听、对峙、不好意思开口这一类画面,人物越克制,越要写细节:
- 眼神短暂停顿
- 手指把号牌捏紧
- 呼吸带动肩膀
- 发丝被热气掀一下
- 嘴唇轻轻抿住
- 坐姿重心往台面挪一点
- 表情从走神变成克制的不安
这些细节不会破坏「她在等面」这件事,却能让人物不像贴在椅子上的海报。
所以写的时候,可以在最后加一句,专门拦住雕塑:
人物不是完全静止。有自然眨眼、轻微呼吸、眼神短暂停顿、手指细小动作。整体克制,不夸张表演。这样人物即使只是坐在原地,也会更像一个真实处在情境里的人。
还假,是静帧里她已经端着面在笑。 变忙,是又加了转头、挥手、对老板说话。 整个人换了,是视频提示词里又把「短发女生」写了一遍,跟第一帧打架。
五、两个人时,别让两边一起演
多人物最容易假,是因为你让每个人同时做动作。 【三十六】练过:两个人不要抢同一秒。这一节补一句更细的:不是谁动谁不动就够了,是一个人先把事情做出来,另一个人被这件事碰到。
比如吧台上多了一个人:后厨把面递到她面前。如果只写:
生成单镜头。固定镜头。无台词。无背景音乐。
老板把面放到她面前,她抬头看他,两人对视,动作自然,电影感。
这段虽然有互动,但还是比较表面。因为两个人为什么对视?她是饿了、愣了,还是在确认这碗是不是自己的?如果这些没有写清楚,画面就容易像摆拍。
多人物的关键,不是动作越多越好,而是要有一方行动,另一方反应。
可以改成:
这样写,人物之间就有了关系:
老板先放碗, 她听到、看到后停顿、抬眼、克制反应, 老板再停住,形成一种很短的、安静的确认。
这比「两个人对视」更像真实视频。
多人物可以记住一句话:不要让所有人都表演,要让一个人触发事件,另一个人产生反应。
比如:
- 一个人把碗放下,另一个人没有立刻拿筷
- 一个人报号,另一个人沉默片刻才抬头
- 一个人伸手推面,另一个人眼神先躲开碗沿
- 一个人停住,另一个人这才察觉到热气扑到脸上
- 一个人看向她,她先看号牌,再慢慢看碗
这一类互动,会让人物之间产生真实关系,而不是各自站在那里摆姿势。
所以写两个人时,不要只写「他们在做什么」,还要写清楚:
谁先行动,谁在反应,反应有多轻,气氛发生了什么变化。
还假,是两个人同一秒抬头微笑。 变忙,是 8 秒里写进了放碗、说话、吃面、结账。 抢戏,是两边的手同时伸向同一只碗。
这一节怎么用
先问一句:你写出来的那段词,是一份「她正在经历什么」的说明书,还是一份动作清单?是动作清单,就先别补自然生动、再流畅一点、再有电影感。
- 脸对、店对,人一动就假,先删转头微笑、自然生动、动作流畅
- 会动仍像体操,检查三处:有没有一件正在发生的事,动作有没有被打断,打断之后她停在哪
- 单人时按格子填:坐哪、正在干嘛、被什么打断、身体连续怎么变、漏出哪一下
- 不能大动时,靠眨眼、呼吸、手指、重心,不要给她一场戏
- 两个人时,一个人先做完那件事,另一个人再反应;反应要轻
- 先出「面前没有碗」的静帧,再跑图生视频;视频里只写先后,不写她是谁
单人在店里等一样东西,按这个填:
| 成片什么样 | 别急着加 | 先改哪一步 |
|---|---|---|
| 人会对着镜头做标准转头、标准微笑 | 再自然、微表情细腻 | 删看向镜头、微笑;给一件正在等的事 |
| 手、头、头发同时开始演 | 动作更丰富 | 先让旧动作停住;再让新动作发生 |
| 人像会微微呼吸的海报 | 电影运镜、再推近 | 固定镜头;写被什么打断;写打断之后看向哪 |
| 两个人同时抬头对视 | 对手戏、更有故事 | 谁先放碗;谁先停住;反应写轻 |
| 人突然开口,或切了第二个景 | 旁白、更生活 | 开头写死:无台词;生成单镜头 |
再记四句,生成前当验收:
- 先给事,再给动作。 说不出她正在等什么、被什么打断,不许写转头微笑。
- 8 秒只走一座桥。 等到被打断已经够了。吃面、吸一口,是下一条。
- 所有动作写出后果。 号牌还在手里,碗还没上来。只写「拿面」,模型会发给你终点。
- 静帧钉住人货灯,视频只负责把那件事走完。 底图已经在交体操,视频里再写自然生动,假会更假。
课后只跑这一家拉面店。先用开场那句体操词出一条对照;再按「被漏号打断」跑第一节;再跑转筷子被叫号打断;再跑出神被碰盆拽回来;最后把「面前没有碗」的静帧当首帧,视频里把风格词、身份词、微笑词全部删掉。
看的时候不要先问清不清、像不像电影。先问:这八秒里有没有一件正在发生的事。她是不是先停住,再抬眼。号牌有没有提前消失。碗有没有从空气里长出来。
句子里还在写自然生动、动作流畅、缓慢转头、轻轻微笑、请给我专业提示词,就删。先让这八秒,从一张还没被叫到的号码牌上走完。

暂无评论内容