
很多新手第一次做图生视频,都会走进同一个坑:
打开对话框,把能想到的词全倒进去。电影感、8K、虚幻引擎、光影高级、运镜丝滑、人物情绪饱满……写到两三百字,自己读一遍都觉得专业。点生成。等了几十秒。出来的片子:人还是那个人,景还是那个景,动作却像在梦游。
这时人最容易怪模型:“是不是这个工具不行?”
其实更常见的原因是:你把一段人类觉得很完整的说明书,交给了一个只认画面、不认形容词的系统。
视频模型和聊天模型不一样。你跟 ChatGPT 说话,它会尽量听懂你的意图。你跟视频模型说话,它真正在做的事情更像是:
看着你上传的那张图,再看看你写的字,决定这几秒钟里,哪些东西该动、怎么动、动多少。
字写得越多,不代表它越明白。字写错了位置,它反而会把力气用错地方。
下面三件事,是我带新手改提示词时改得最多的。改完之后,同样一张图、同一个模型,成片通常会立刻稳一截。你不需要背公式,只需要先搞懂:视频提示词到底在指挥什么。
先记住一句大白话
做图生视频时,把工作分成两截:
- 图负责“长什么样”:风格、光线、颜色、质感、构图,几乎全由第一帧说了算。
- 字负责“接下来怎么动”:谁在动、动什么、镜头跟不跟、这几秒里先发生哪一件事。
你如果把“长什么样”又在文字里写一遍,还写得很用力,模型就会分心。它本来该把算力拿去算头发怎么飘、手指怎么翻、蒸汽怎么散,结果被你拽去理解“赛博朋克”“电影级”“超高清”。这些词对一张已经画好的图来说,大多是噪音。
另外先说清楚:下面所有提示词都用中文。MetaDig、即梦这类模型,中文写动作已经够用了,不必为了显得专业去写英文。
所以这篇文章不教你堆更长的词。只教你三件事:
- 别跟第一帧抢权
- 一条镜头只许有一个主心骨
- 把“同时发生”改成“按秒发生”
第一件事:别跟第一帧抢权
1. 风格词,在视频阶段基本是空转
新手最容易把文生图那套习惯原封不动搬过来。
文生图阶段,你写“晨光、木质桌面、浅景深、胶片颗粒”,这些词有用,因为那时候还没有图,模型要靠文字凭空长出画面。
可你一旦已经有一张图,再去做图生视频,局面就变了。那张图已经把风格钉死了。视频模型的第一优先级,几乎永远是:尽量别把原图弄丢。
你再往提示词里塞一堆画质词、引擎词、风格词,它通常不会听话地把画面“升级”成另一种美学。更常见的两种结果是:
- 它发现这些词和原图打架,直接当废话丢掉
- 它分出一部分注意力去消化这些词,真正该做的动作变得又慢又糊
你可以把它想成拍戏。已经把服装、布景、灯光都布置好了,导演进来只该喊:“她伸手去拿杯,蒸汽往上飘。”你要是还在旁边喊“改成科幻片!改成游戏CG!改成8K广告大片!”,现场不会变成科幻片,只会乱。
案例 A:浴室洗手台上的精华液
先看这张首帧在讲什么。
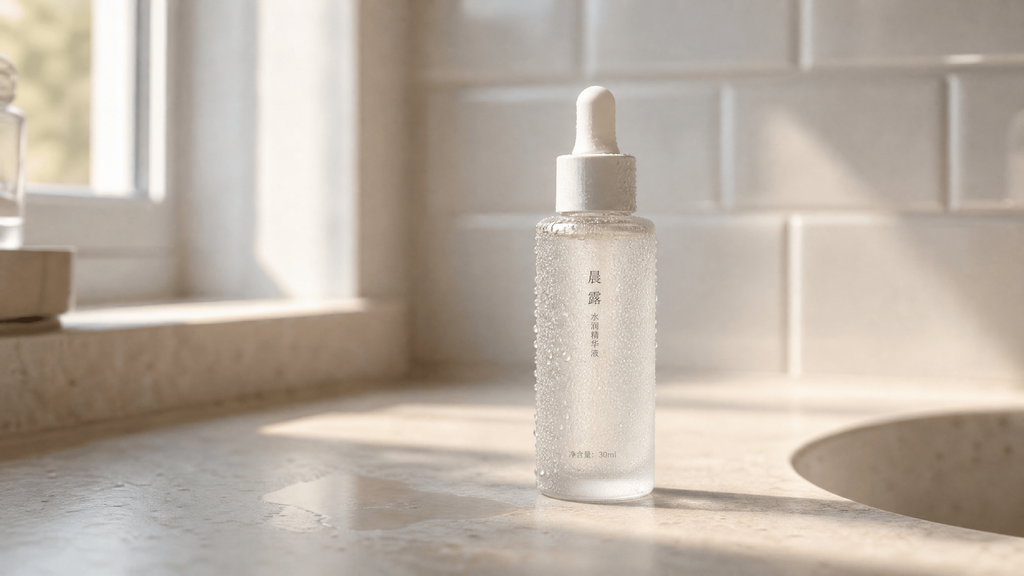
画面是一瓶磨砂玻璃的精华液,放在浅色石材洗手台上。瓶子上有一层细细的水珠,晨光从左侧窗户进来,台面上有一块湿痕,背景是虚掉的白瓷砖。整体很干净、很轻、偏生活感,完全不是炫技大片。
如果你是文生图,可以这样出这张图(这是出图提示词,先用来生成第一帧,不要拿去生成视频):
图有了。下一步很多人会这样写视频提示词:
别这样写:
赛博朋克霓虹,虚幻引擎5顶级渲染,超高清8K,电影级光影,高级质感拉满,瓶子缓缓旋转一圈,最后正面朝向镜头。看起来很“会用 AI”。实际会发生什么?
瓶子多半还是那个瓶子,浴室也不会长出霓虹灯。模型一看:原图是清晨湿润的洗手台,文字却在喊科幻渲染。为了不把原图拆掉,它会把“赛博朋克、UE5、8K、电影级”这些词压下去。你以为自己在加分,其实只是在提示词里制造了一堆空转。
更糟的是,旋转这个动作也会被拖累。该转得干脆的地方,变得犹豫;水珠该顺着瓶身滑的地方,滑得不明不白。因为权重被风格词抢走了。
注意这句里有什么、没有什么。
有的全是眼睛能看见的物理变化:转、滑、光在挪。 没有的是所有“让画面更好看”的形容词。
好看这件事,原图已经做完了。视频这几秒,你只需要让它“活”。
你可以自己做一次对比:同一张图,先用满是风格词的版本出一条,再用只写动作的版本出一条。大多数时候,第二条的水珠、反光、旋转都会更清楚。不是因为你写得更高级,是因为你把模型的力气还回去了。
2. 数字指令,模型基本听不懂
第二个坑更隐蔽。很多人觉得自己已经“科学”了,开始写参数:
风速6级,水珠以每秒2厘米下落,瓶子旋转90度,镜头推进30厘米。这在人类世界里很精确。在视频模型里,它常常等于没说。
原因很简单:模型没有尺子。它看不见你房间里的米和厘米,也没法把“6 级风”换算成这张图里头发该扬起多少像素。它认的是画面里已经有的东西发生了什么可见变化。
还是浴室这张图。如果你想表现“风从窗户进来了,有点大”,不要报气象数据。
别这样写:
风力达到6级,非常大。水珠以每秒2厘米的速度往下滑,瓶子在3秒内旋转90度。两段话的差别,不是文采,是参照物。
“6 级风”是抽象概念。 “水珠连成细线、湿痕晃动、水珠从瓶口滚到中部”是模型能画出来的事。
再举一个更好懂的:你想让一个人在雨里往前走。
不要写:
他以每秒1米的速度走了5米,风力6级,雨很大。走了多远不重要。踩水坑、裤脚湿、伞被掀,这三件事一出现,观众就知道:雨大、风大、人在往前走。模型也一样,它靠这些零件拼出运动,不靠你报数。
这一节请你带走的习惯:
- 风格、画质、引擎名:视频阶段能删就删
- 米、厘米、级、角度、秒速:改成画面里的东西发生了什么
- 提示词越短越好?不是。是每一句都要能被眼睛核对
写完自己读一遍,问一个问题:如果把这句拿去跟摄影师说,他能拍出来吗?拍不出来的,多半也生成不好。
第二件事:一条镜头只许有一个主心骨
第一个问题是写了没用的词。第二个问题更麻烦:词都有用,但它们在互相打架。
新手很少觉得自己在写冲突指令。大家只是习惯性把网上看到的“高级词”拼在一起:
- 想要情绪,就写手持晃动
- 想要高级,就写平滑推轨
- 想要质感,就写影棚硬光、戏剧对比
- 想要自然,又舍不得删原图里的窗户光
于是提示词变成一个谁也不得罪的拼盘。问题是,视频模型不是服务员,不会把每道菜都端上来。它更像一个必须当场做决定的摄影师:你既要晃,又要稳,它就给你一个什么都不是的慢移。你既要影棚硬光,原图又是柔和窗光,它为了保住原图,会把打光那句直接丢掉。
画面不会崩。它只是变得平。平到你说不出哪里错,只觉得“怎么还是好假”。
假,经常不是因为细节不够,是因为这条镜头没有主心骨。
拍广告和拍情绪片,用的不是同一套身体。广告要稳、要清楚、要产品被看明白;情绪片可以呼吸、可以晃、可以停。你必须先选一个。选完再写。
案例 B:深夜便利店收银台
首帧是这样的:
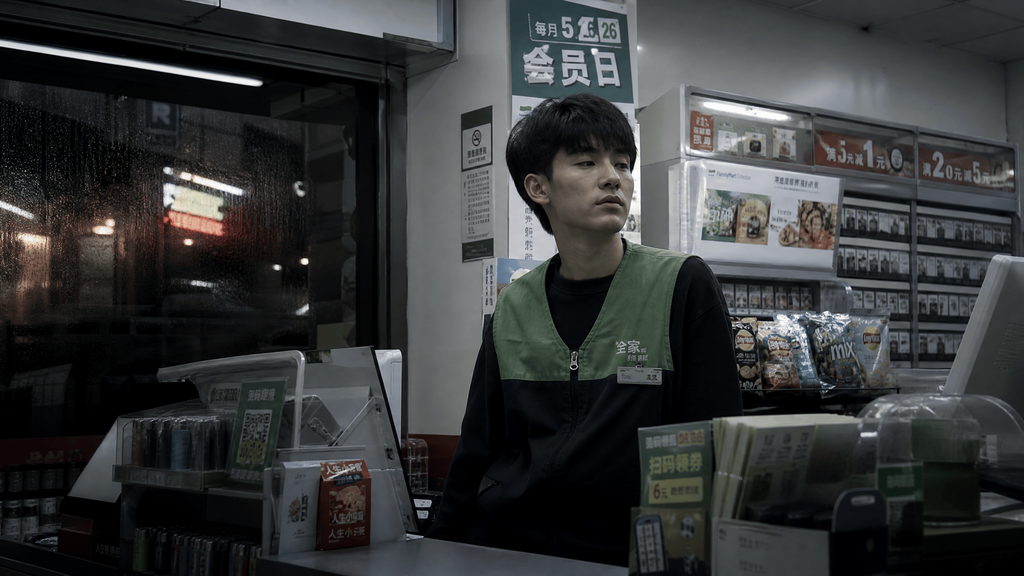
一个年轻店员靠在收银台后面,穿着便利店马甲,头顶是冷白的灯管,货架上的包装袋反着光。窗外是被雨水模糊的街道。人没有大笑,也没有摆姿势,就是班快结束时那种有点空的安静。
出图可以用:
很多人为了“更像电影”,会写出这种视频提示词:
别这样写:
电影级运镜,强烈肩扛手持展现疲惫情绪,同时镜头缓慢且极其平滑地向前推进。戏剧性的高对比度影棚打光,店员轻轻转头看向窗外。这里至少有两处对打:
- 手持晃 和 平滑推 是两种完全不同的镜头身体。一个在呼吸,一个在滑轨上走。模型为了两头都照顾,最后经常给你一段又慢又死的平移。你要的疲惫感出不来,广告的干净也没有。
- 影棚硬光 和原图的 灯管冷白光 不是同一种光。模型会保原图。打光那句大概率作废。你还以为自己控制了光,其实一个字都没生效。
先问自己一句: 这条片子到底要什么?
如果要的是“下班前那一点空”,主心骨就应该是安静,不是炫技。
这句看起来“不够专业”。但它做对了三件专业的事:
- 运镜只留一种:固定
- 光影不重新发明:保持原有灯光
- 动作只做一件半:敲柜台,再看窗外
固定机位不是偷懒。当人物动作很小的时候,镜头越动,越像在掩盖你没想清楚。把镜头钉住,模型才会把细节算在手指、眼神、窗外雨丝上。
如果你的目标其实是广告,主心骨就该换成“清楚、稳定、把货架和人说明白”。那你可以写缓慢前推,但请删掉手持。两种里只能留一种。不要既要情绪的晃,又要广告的滑。
这一节请你带走的判断题:
写提示词之前,先在纸上写一个词,只能写一个:
- 静
- 晃
- 推
- 跟
写完再检查提示词里有没有第二个运镜。有,就删。 再检查有没有和原图光线相反的打光词。有,也删。
一条镜头像一碗汤,主味只能有一个。葱姜蒜可以少放,不能又是麻辣又是清淡还要奶香。
第三件事:别让所有动作在同一秒抢戏
前两个问题,一个是写了空词,一个是写了反词。第三个是写了太多真词,而且要求它们一起发生。
比如你心里有一场很完整的戏:风来了,东西被吹起来,人有反应,镜头再转一圈。于是你写成一句长话,用“同时”“并且”“还要”把它们串起来。
人类听这段会觉得很燃。模型听这段会很为难。因为它要在短短几秒里,把运动算力分给每一个要求。分到每个动作头上的力气就变薄了。于是你看到:
- 该猛的风,只是轻轻抖了一下
- 该站起来的人,像是腿没长结实
- 该转的镜头,转得又急又没来由
不是模型不会做大动作。是你让它同一秒当三个演员、一个摄影师、一个场务。
视频提示词的进阶,不是把句子写得更文学,而是把句子写成简陋的分镜表。
给每一秒规定:现在谁是主角。
案例 C:早餐店里掀蒸笼
首帧:
一个穿深色围裙的老板站在小店不锈钢台面后,面前是一屉刚出锅的竹蒸笼,盖子还没揭开。晨光从门口打进来,空气里能感觉到热气。桌上有一碟红油和几双筷子。人是中景,蒸笼在画面下半部分,很清楚。
出图可以用:
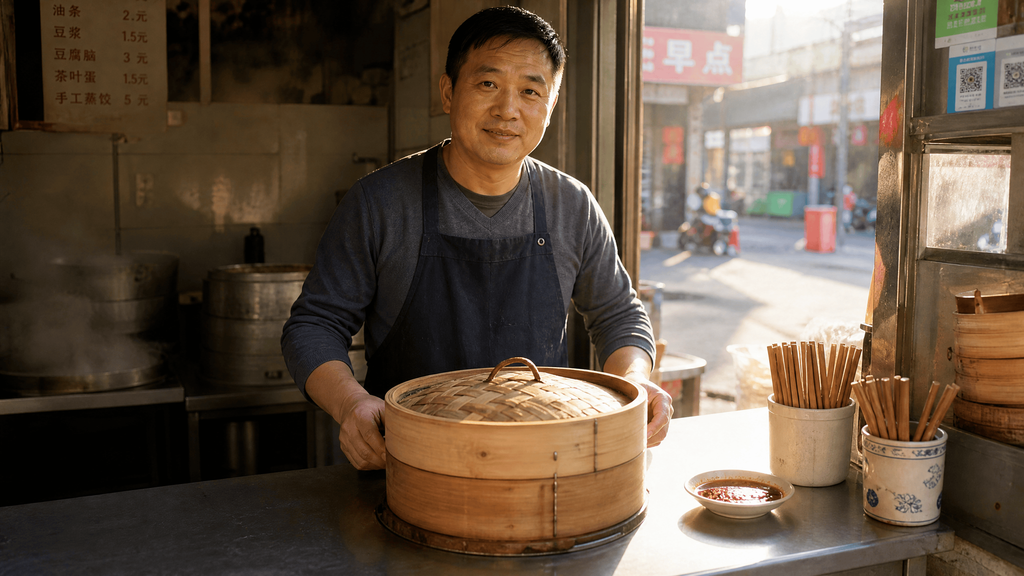
心里想要的戏很完整:热气冲出来,老板揭盖,客人那边有反应,镜头再绕一圈很燃。于是容易写成:
别这样写:
蒸笼盖猛地揭开,白气瞬间冲上天,老板一边揭盖一边转身去拿酱油,镜头同时360度环绕,店门口还有顾客探头进来看。这不是一条镜头,这是四条镜头叠在同一秒。模型会尽量都做一点点:气散得没形状,手的动作发飘,环绕突兀,顾客像贴图。燃不起来,只觉得忙。
为什么这样写会稳很多?
第一,每一段只有一个核心任务。 0-2 秒算力给“漏气”,2-3 秒算力给“揭盖和蒸汽”,3-5 秒算力给“人的反应”。模型不用在同一帧里既算蒸汽物理,又算身体转身,还算环绕轨迹。
第二,动作有因果关系。 因为热,所以先漏气;因为揭盖,所以气涌出来;因为热气扑脸,所以他擦汗。观众吃的就是这个顺序。没有顺序的运动,看起来就像几张表情包在闪。
第三,内部已经够忙了,镜头就别再抢。 揭盖、蒸汽、包子显现、擦汗,已经是一条完整的生活戏。这时再加 360 环绕,空间会晃,细节会糊。想要高级,先把内部运动做实,镜头能不动就不动。
如果你后面真的想要镜头动,也请单独开一条:例如下一条 5 秒再“缓慢靠近蒸笼”。不要和揭盖抢同一条。
一个能直接套用的空表:
写的时候检查三遍:
- 同一秒里有没有两个主角?有,就拆开。
- 后一段是不是前一段的结果?不是,就改到有因果。
- 镜头运动是不是必须的?不是,就写固定。
到这里你会发现,所谓“会写提示词”,常常不是会堆词,是会排队。
把三件事收成一个能上手的流程
下次你准备把一张图做成视频,不要打开对话框就开始抒情。按这个顺序来:
第一步:盯着原图,说出它已经有的东西。 光线是窗光还是灯管?颜色偏暖还是偏冷?人是近还是远?这些都不要再写进视频提示词,除非你只写一句“保持原有光线”。
第二步:只决定一件运动。 这一条视频如果只能成功做成一件事,你最想做成哪件?瓶子上的水珠下滑?店员看窗外?蒸笼揭盖?选定以后,其他动作要么删,要么排到后面几秒。
第三步:检查有没有内斗。 手持和平滑不能同时在。影棚光和窗光不能同时在。狂风、人物猛动、镜头环绕,尽量不要同一秒。
第四步:能写成时间线就写成时间线。 即使只有 8 秒,也请标出 0-2、2-5、5-8。这不是为了看起来专业,是为了强迫你给模型一份工作安排,而不是一堆愿望。
第五步:删形容词,留能看见的变化。 “非常大的风”改成“围裙被吹起来”。 “很伤心”改成“眨眼变慢,肩膀塌下去一点”。 “高级质感”直接删。
三句可以贴在显示器边上的话
- 图已经决定了长相,字只负责让它动。 风格词、画质词、引擎名,视频阶段多半是空转。
- 一条镜头一个主心骨。 先选静、晃、推、跟其中一种;光线尽量跟原图走。冲突的词不会让画面更丰富,只会让控制力变零。
- 运动要排队,不要挤门。 把环境、人物、镜头拆开,按秒写。先发生什么,才引起什么。这是从“碰运气生成”变成“还能改第二版”的分界线。
给你一条今天就能练的作业
找一张你自己的图,最好是生活里能看懂的:一杯咖啡、一盘菜、一个人坐在桌前、一只宠物、一件放在桌上的产品。不要选大场面。
然后只做三次生成:
- 第一次:把你平时会写的长提示词原样丢进去,留下结果。
- 第二次:删光所有风格词和数字,只留一个动作。
- 第三次:把这一个动作拆成 8 秒三段,镜头写死为固定。
三版并排看。你要找的不是“哪条更炫”,而是哪条的动作更扎实:水有没有在流,手有没有在碰东西,蒸汽有没有在涨。
扎实的那条,才是以后能商用、能进剪辑、能反复改的底子。炫的那条,往往只是提示词在表演专业。
AI 视频不是比谁写得长。是比谁更清楚:这几秒钟里,到底谁在动。

暂无评论内容