
先说一个很常见的情况。
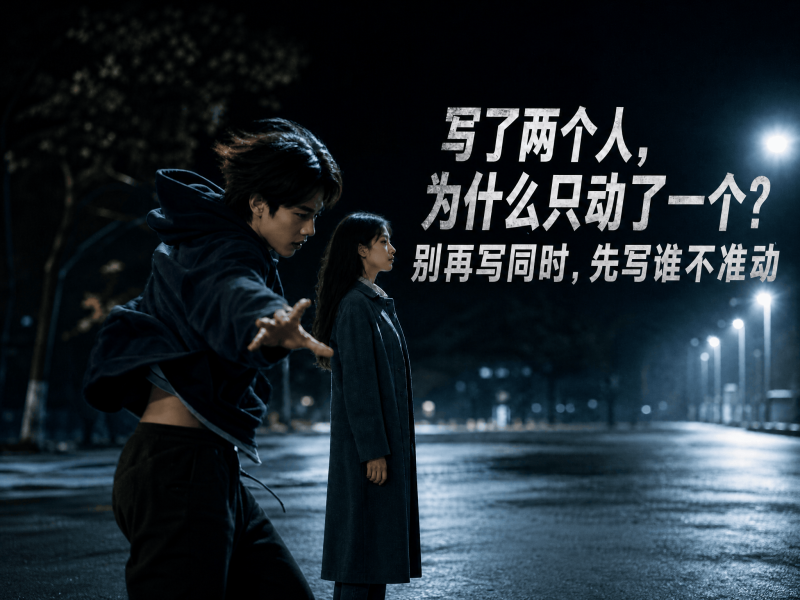
单人的时候,模型挺听话。人怎么站、手怎么动,你写了它就画。一加上第二个人,麻烦就来了:左边刚对,右边开始发呆;右边动作对了,左边的手却去干右边的事。你明明写得很通顺,出来的却像两个人抢同一具身体。
所以问题通常不在词够不够细。 「同时、接着、然后」你看得懂。模型缺的是:这一秒注意力该给谁、左右各站在哪一块、你到底要留下哪一个、高潮是不是被塞进了同一条长镜头。
很多人会这样写:
场景写完 → 把两个人的动作写进同一句 → 再加「同时、接着」 → 一个人听话,另一个当背景板,或者两个人的动作糊成一团
模型接到的不是一段对手戏,是一张任务单:请同时养活两具身体、两套动作、一套先后顺序。它最省事的做法,就是保住声音最大的那一个,把另一个冻住,或者把两套动作叠到同一个人身上。
你可以先记住一句很软的口诀:
通顺交给人看。交给模型的,只留三件事:谁在左边谁在右边、这一秒只许谁动、满意的那个绝对不能被改掉。
本节就练这三步:
- 两人一写就开始抢戏:别写成通顺的故事,先划左右、再划秒数
- 只想改一个,另一个也被刷掉:别整段重抽,先写死谁留下、再写只改谁
- 动作不崩,成片却像没剪过的彩排:别把一套动作塞进一条全景,先拆成特写、中景、全景再接上
【二十三】练过一次别让模型同时干太多活。【二十七】练过别把动作写成待办。【三十三】练过先把空间、动作、节奏握在自己手里。【三十五】练过别把情绪画在脸上。 这一节接在后面:一个人已经能站住了,别再让第二个人来抢同一句注意力。
下面三步,用同一个小场景跑完。夜里,小区快递柜前,两个人并排站着取件。场景不用换,换的是你让模型一次只看谁。
开场:先出一段「两个人都在动」的视频,看看它到底差在哪
试一下这句:
夜里小区快递柜前,左边男生在输取件码,同时右边女生抱着纸箱打电话,接着男生站起来把门拉开,超写实,电影感静帧多半还不丑:柜子在,灯在,两个人也在。一让它动,常见是这三种翻车:
- 女生电话打得很像,男生却端着手机做出拉开柜门的手势
- 男生输码很认真,女生整段站着不动,像被贴在柜子上的背景板
- 两个人的手同时伸向同一格柜门,像在抢同一个包裹
这句其实只交了四个标签:夜里、快递柜、两个人、电影。 左边这块地归谁,右边这块地归谁,0 到 3 秒谁在干活,4 秒之后谁保持不动,模型全不知道。于是它走默认作业:听见两个动词,就尽量同时做完。
生活里很好对一下。你站在快递柜前,并不会一边输码一边替旁边那个人打电话。你是各管各的格子。观众也一样:先看清谁在左边、谁在右边,再看这一秒到底是谁的手在动。
一、两人一写就开始抢戏:别写成通顺的故事,先划左右、再划秒数
「同时、接着」对你来说是时间顺序。对模型来说,更像两个喇叭一起响。它听得见词,分不清这一秒该把力气押在谁身上。结果往往是:保住一个,冻住一个;或者把后发生的动作提前叠到还没做完的人身上。
你可以换一个想法:别把两个人的一生写进一句通顺的话。先给每人一块地,再给每一段几秒钟。 地界清楚了,动作才不会串台。
男生在左边输码,女生在右边打电话——你会觉得这是两个人在各干各的。男生一边输码一边做出拉开柜门的手,你会觉得他们在抢戏。
差的不是动作不够细,是两个人挤在同一句注意力里。
❌ 别这么写:
夜里快递柜前,左边男生正在输取件码,同时右边女生开心地打电话,接着男生站起来拉开柜门鼓掌一样地回头看她出来通常是:女生电话是对的,男生的手却既要按屏幕又要拉门,身体拧成一种很奇怪的「我在同时做两件事」。你写得越通顺,它越容易把「接着」当成「现在也一起做」。
✅ 先划地界,再划秒数,可直接跑:
同一招可以写轻一点。不必给每个人写一篇人物小传,只留三件能分开的东西就够:左边是谁、右边是谁、下一秒谁保持不动。衣服颜色不同,是为了让模型认人,不是为了好看。颜色一混,左右就会开始借身体。
写完可以问自己三句:左右有没有写成「左侧区域 / 右侧区域」,而不是「一个男生和一个女生」?每一段秒数里,有没有写明谁保持不变?「同时、接着」删干净了没有?
二、只想改一个,另一个也被刷掉:别整段重抽,先写死谁留下、再写只改谁
第一节会了之后,你可能已经抽出一段还不错的:右边女生打电话很自然,光也对。你只是嫌左边男生输码输得太呆,想让他改成「把卡住的纸箱往外拽」。
这时候最容易手贱:回到原提示词,加一句「左边男生换个动作」,再点重新生成。模型听懂了「换」,没听懂「只换一个」。它会把整段推倒重来。右边那个你已经满意的人,头发、站位、光,全都重新抽一遍。
画蒙版去抠,也常翻车。视频里人在动,框不住每一帧,边缘会闪,像一张贴上去的贴纸。
你可以换一个想法:已经满意的那一侧,不是拿来重抽的,是拿来锁住的。 现在的视频工具里,多半都有「视频编辑 / 局部修改」。一句话就能改,但有一个坑绝不能踩——你不说留下谁,它默认全部推翻。
❌ 别这么写:
左边男生换个动作,把纸箱从柜子里拽出来,电影感出来通常是:男生倒是在拽箱子,女生换了一张脸,外套颜色变了,快递柜的灯也换了一种。你改的是一个人,它交的是另一条片子。
✅ 先写死留下谁,再写只改谁,可直接跑:
同一招换轻重:留下的人要写具体,不能只写「右边的人别动」。站位、衣服、手里那件东西、身上那束光,点得越死,模型越不敢乱动。改的人只写一个新动作,不要顺便给背景加戏。
检查时看三件事就够。有没有先写「锁定 / 保持 / 完全不要改」——不写,模型会当成整段重做。留下的那个人,有没有写出至少三件可核对的细节(衣服、动作、光)。改的那个人,有没有被写成「仅修改」,而不是「再生成一个男生」。
三、动作不崩,成片却像没剪过的彩排:别把一套动作塞进一条全景,先拆开拍再接上
环境和左右都管住了,两个人也能同时存在了。可你把高潮写成一套连续动作,塞进一条 8 秒全景,人往往不崩,片子却像没剪过的彩排:输码、拉门、拽箱、转身、差点撞上,全在同一个距离里发生。你看见事情做完了,看不见哪一下该让人屏住。
有人会说:现在模型很强,这么多动作塞进去,手脚也不会乱。这是真的。正因如此,才更要拆。不崩只说明身体还在,不说明这场戏被拍过。
差的不是动作清单不够完整,是镜头一直站在「把两个人都拍全」的距离上。
❌ 别这么写:
男生输完取件码,拉开柜门,把卡住的纸箱拽出来,转身,女生被吓到回头,两个人差点撞上,电影感长镜头出来通常是:全景,两个人从头演到尾。柜门、纸箱、转身、惊吓全有,但每一下都小小的、小小的、像在完成任务。你看见流程,看不见那一下卡住、那一下拽出来、那一下差点撞上。
✅ 把高潮拆成三个阶段,可直接跑:
第一段,特写,只拍开始之前。
第二段,中景,只拍那一下爆发。
第三段,全景,只拍撞上之前那一下。
三段分别生成,再按顺序接上。
这里有一件事很容易强迫症。三段背景不可能砖缝对砖缝。你只要每段都写同一句环境:「夜里小区快递柜,冷白荧光灯」,就够了。景别一切换,观众盯的是手、箱子、两个人快撞上的那一下,柜子上那点差别会被自动忽略。硬要三段背景一模一样,反而会把时间耗在永远抽不齐的墙上。
写完看三件事:每一段是不是只干一件事,而不是把拽、转、撞写进同一条;开头有没有景别(特写 / 中景 / 全景);环境有没有写成同一句,而不是去对每一块瓷砖。
总结:多角色不是写得更细,是三件不让模型抢注意力的事
| 你卡在哪 | 别急着加 | 你最后只写什么 |
|---|---|---|
| 两人一写就开始抢戏 | 别写同时 / 接着 / 然后 | [0-3秒] 左侧谁;右侧谁 → 下一秒写「另一侧保持不变」 |
| 只想改一个,另一个也被刷掉 | 别改原词整段重抽,也别靠蒙版硬抠 | 先锁定满意的那个人(衣服、动作、光),再写仅修改另一个 |
| 动作不崩,却像没剪过的彩排 | 别把一套动作塞进一条全景长镜头 | 特写按错码 → 中景拽卡住的箱 → 全景快撞上,再接上 |
如果只想带走三句,可以是这三句:
- 先划地界,再划秒数。 两个人不要挤在同一句里抢注意力。
- 先写留下谁,再写改谁。 你不说保留,模型就当全部作废。
- 高潮要拆开拍。 人不崩不等于拍过。特写、中景、全景各干一件事。
课后还是只跑通一个题目,场景不要换:
- 用开场那句先出一段,留下这段两人抢戏、动作糊在一起的成片。
- 换成第一节:左侧输码,右侧打电话,下一秒右侧保持不变,只让左侧拉门。
- 换成第二节:锁定右侧打电话的女生,只改左侧男生去拽卡住的纸箱。
- 换成第三节:特写按错码,中景拽箱,全景快撞上,三段接起来。
四步走完,你手里会是同一排快递柜、同一对夜里取件的人。差别只在于:你有没有把「请两个人一起把故事演完」这件事关掉。
工具过几个月就会换。 先习惯问这三句就够了:谁在左边谁在右边,这一秒只许谁动,满意的那个有没有被写死留下。

暂无评论内容