
你不是缺镜头词。你是把「广角、特写、浅景深、电影感」当成同一层滤镜往上贴,模型只能给你一张透视打架的缝合照。
你习惯这么干:
场景写完 → 再加「广角、特写、浅景深、电影镜头、8k」 → 脸被拉歪、人又远又近 → 再换一组更炫的镜头词
模型收到的不是导演指令,是一堆互相打架的拍摄条件。 你觉得自己在调情绪。它觉得你在说「把这张图弄得更像电影一点」。
口诀:情绪自己留,镜头只写两件事:观众站多远,空间是拉开还是压扁。
本节只练三件事:
- 想孤独却拍成证件照:别写孤独,先决定人在画面里有多大
- 想压迫却脸被拉歪:别广角长焦一起塞,先决定空间是拉开还是压扁
- 词都对、图却假:别让相反的物理叠在一句里,景别、焦段、虚实必须同一套逻辑
生成时请带着一张「人在,情绪不在」的图开工。没有对照,这三招会重新变成背单词。
【三】练过相机站多高、用哪只眼睛看。【九】练过空间怎么往里走。【三十一】练过明暗、冷暖、虚实。 这一节专门练你已经会写「怎么拍」之后,别再把所有镜头词叠进同一句。
开场:你贴的不是镜头,是一张缝合怪
试一下这句:
夜里过街天桥一个女生,广角,特写,浅景深,电影镜头,8k,电影感出来的十有八九是:脸很大,身后一整条桥也在,栏杆被拉弯,背景又糊又近。 精致,但像把证件照、风景照、广告片三张图焊在一起。
因为你只交付了四个标签:夜里、广角、特写、电影。 没交付模型真正要的东西:
- 观众离她有多远:是对街看一个小点,还是走到她跟前看半张脸
- 空间是被拉开(近处很大、远处退走),还是被压扁(身后的楼贴到后脑勺)
- 这三种要求能不能同时成立
人脑可以靠「电影感」脑补一场夜戏。 AI 不会。它听不懂诗,只听得懂能执行的拍摄位置。
真实画面里的情绪,从来不是镜头名词的堆叠。它是三件叠在一起的物理事实:
人占画面多大、透视怎么变形、这三件事有没有互相打脸。
你不把这三件拆开写,模型就用最安全的平均算法糊弄你:脸往中间放、镜头往中间靠、既想装下整座桥,又想看清睫毛。 这就是摆拍感——不是模型不懂镜头,是你让它同时站在三个地方拍。
下面三步,用同一个日常账号封面场景从头跑完:夜里下班,人走在过街天桥上。每一步都有普通人翻车对照,以及能直接抄的中文。
一、想孤独却拍成证件照:别写孤独,先把人变小或把脸凑近
对模型来说,「情绪」不等于距离。 你写「孤独、压抑、有故事」,它最省事的办法是:人居中、腰以上、正对镜头。桥还在,灯还在,只是脸上多了一点忧郁。像把证件照换了个夜景背景。
改法:停止感动模型。像安排站位一样下指令——先规定观众离她有多远。人在画面里的大小,就是情绪的音量旋钮。
场景:夜里刚下班,天桥上空,风有点大。你想要一张「人走在桥上」的图,给日常账号封面用。心里要的是空、远、有点被城市丢掉。手上却只会写孤独,或者反过来,一上来就写特写。
1. 远景:把人从主角降成一个点
人变小,环境变大。观众参与感下降。她不再是「故事的主人」,是「这座桥上的一个视觉元素」。
适用:空、渺小、走不完、被城市吞掉。
❌ 别这么写:
一个女生走在天桥上,孤独氛围,情绪饱满,细节拉满,8k出来通常是:半身像,桥变成背景布。孤独被理解成「脸上写着难过」,不是「人已经小到快看不见」。
生活里很好验证:你在对街喊她的名字,她听不见。那一刻的空,来自距离,不是来自她的表情。 你把镜头怼到鼻尖,再写一百遍孤独,观众也只会觉得这是一张夜景自拍。
✅ 先把人变小,可直接跑:
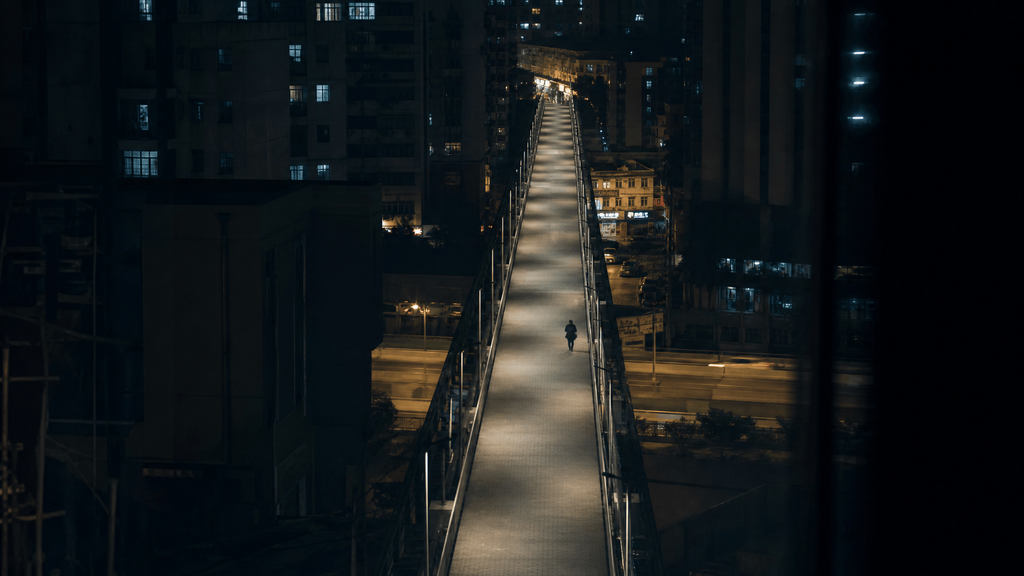
想拍「终于下班了」的松一口气,却用极远景——失败原因一样:表情和肩膀都看不见,观众离得太远,只会觉得画面空。 远景不是高级,是去参与。它强化环境对人的压迫或包容,不负责演微表情。
2. 中景:交代谁、在哪、正在干什么
通常卡在腰以上。最接近生活里跟人说话的距离:上半身动作看得到,身后的桥和灯也还在。
适用:正在走、正在等、正在看手机,平稳地把事讲完。
❌ 别这么写:
中景,一个女生在天桥上崩溃大哭,情绪冲击,电影感,高质量出来通常是:腰以上很清楚,后面广告牌、路人、便利店灯箱全在抢戏。她是在哭,可画面像拍情景喜剧——太平、太远、信息太多。 中景的情绪张力不够。它没有远景的吞没,也没有特写的耳光。高潮戏用它,会把音量拧到「日常聊天」。
✅ 把它当叙事底座,可直接跑:
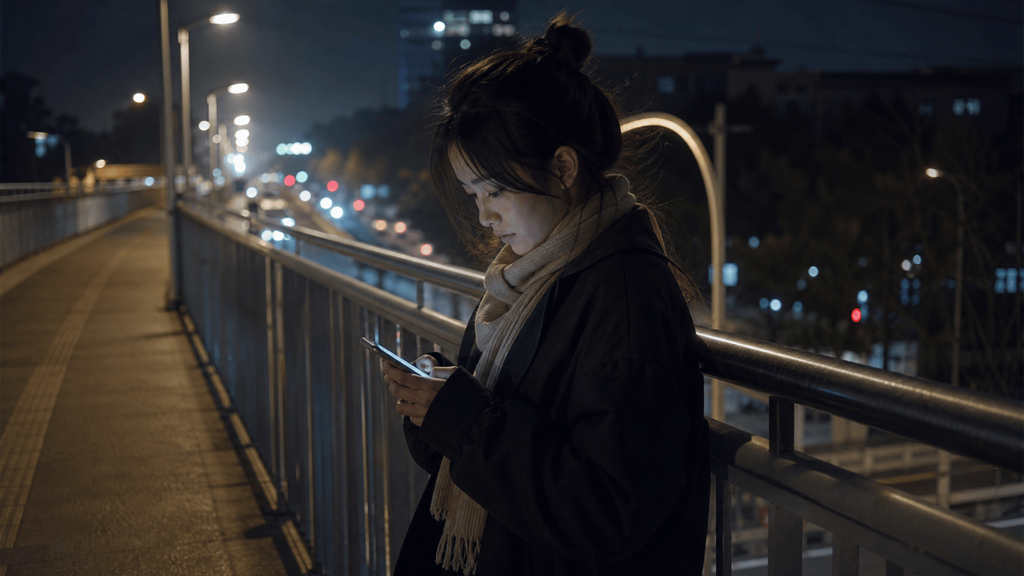
中景负责把事说清楚。谁、在哪、手在干什么。情绪高潮先别交给它。
3. 特写:当高潮武器,不当前菜
特写是把环境剥掉,把脸或手怼到观众眼前。心理安全距离被打破,共情、紧张、压迫才会上来。
适用:撑不住的一瞬间、不敢看的一眼、冷汗、咬住的嘴唇。
❌ 别这么写:视频或图一开场,没有任何铺垫,直接:
极度特写,女生流泪,情绪爆炸,电影感,8k失败原因:观众还不认识这座桥、这个人、这一晚。突然一张哭脸,会生硬,甚至惊悚。成熟的画面,绝不是越近越高级。
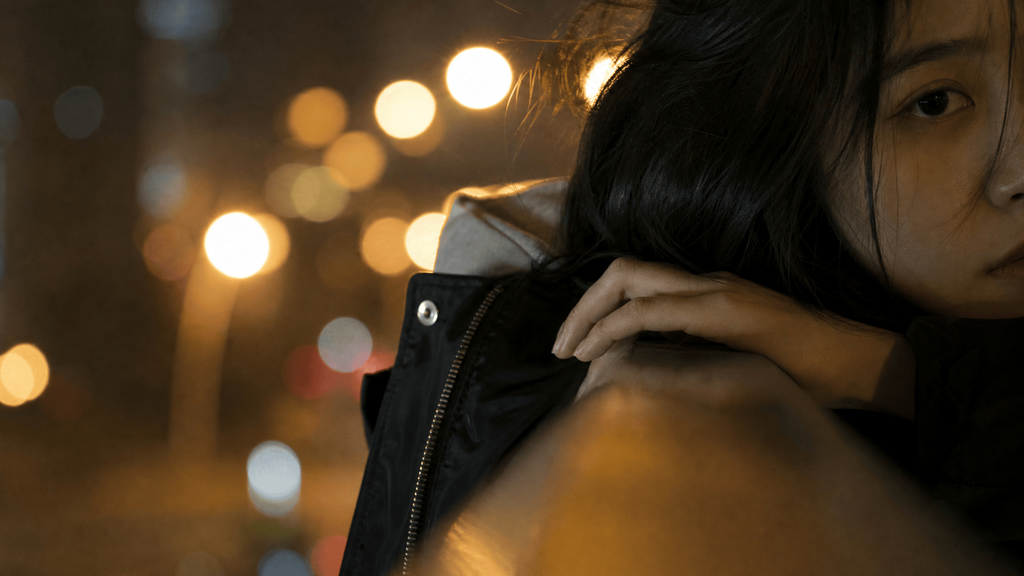
✅ 先让远和中把人安放好,再用特写收口。静帧把画面锁死在「一只眼 + 一根栏杆」上,别再交代整座桥:
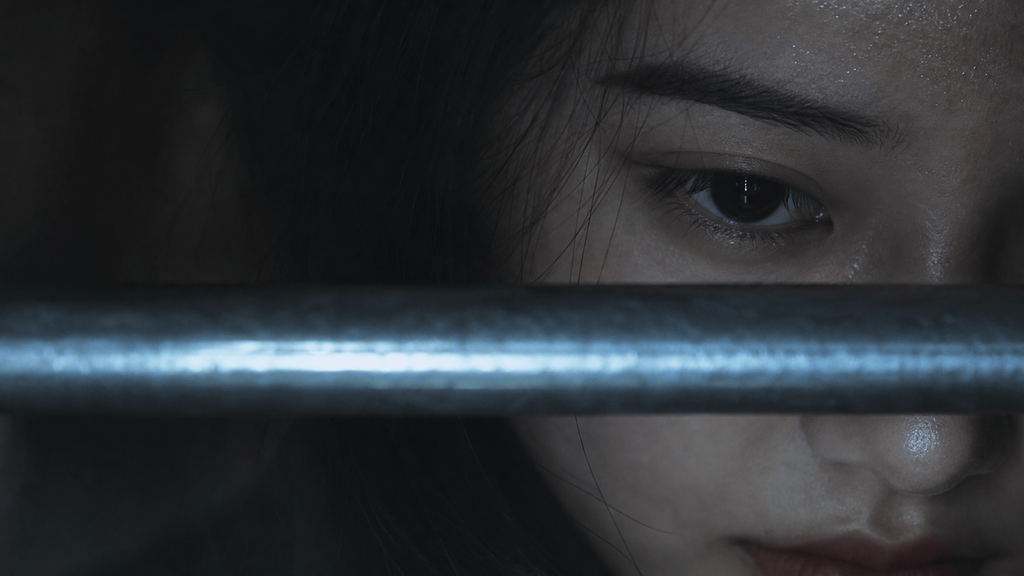
如果是视频,特写必须被前面的距离养出来:
检查三件事:
- 有没有写出「人有多大」。只写孤独 / 电影感,模型会给你标准半身
- 远、中、特有没有各管各的。一句里又远景又特写,就是在要求它同时站在对街和鼻尖
- 「情绪饱满 / 细节拉满 / 8k」是不是已经删干净——这些词会把距离重新搅成平均脸
这就像跟人说话:你不能既在马路对面喊,又贴着耳朵讲。 你负责指定观众站哪。模型负责把那一格距离画出来。
为什么这招有效: 模型默认最稳的是半身摆拍。你不强制「人很小」或「只剩半张脸」,它就不会离开舒适区。 景别不是词汇量,是音量旋钮。远是把声音拧小,特写是把声音拧到最大。
二、想压迫却脸被拉歪:别乱加焦段,先决定拉开还是压扁
【三】里焦段是「用哪只眼睛看」。这一节只问情绪:
你是要把空间拉开,让人被环境吞掉;还是把空间压扁,让人从世界里被单摘出来。
很多人喜欢往提示词里扔「广角镜头、长焦、85mm」,却不知道这些数字改的不是清晰度,也不是「装下多少东西」,是透视。 广角:近处变大、远处退走,边缘会被拉。大脑看到这种非日常比例,容易不安、动荡。 长焦:几百米外的楼被拉到后脑勺,前后像贴在一个平面上。人被隔离,带着一点偷窥和疏离。
两者是相反的物理。写进同一句,脸会歪,桥会贴脸,虚化会假。
1. 要被吞、要不安:用广角把空间拉开
适用:人被城市压住、雨夜地面贴过来、对峙、脚步从镜头前冲过。
❌ 别这么写:
广角,天桥人像特写,脸部细节,电影感出来通常是:鼻子变大,栏杆弯成弓,脸像贴在鱼缸上。广角负责空间,不负责证件照。贴脸用广角,是在惩罚五官。
✅ 让广角去干它会的事——把桥拉长,把人变小,把地面推到镜头前:
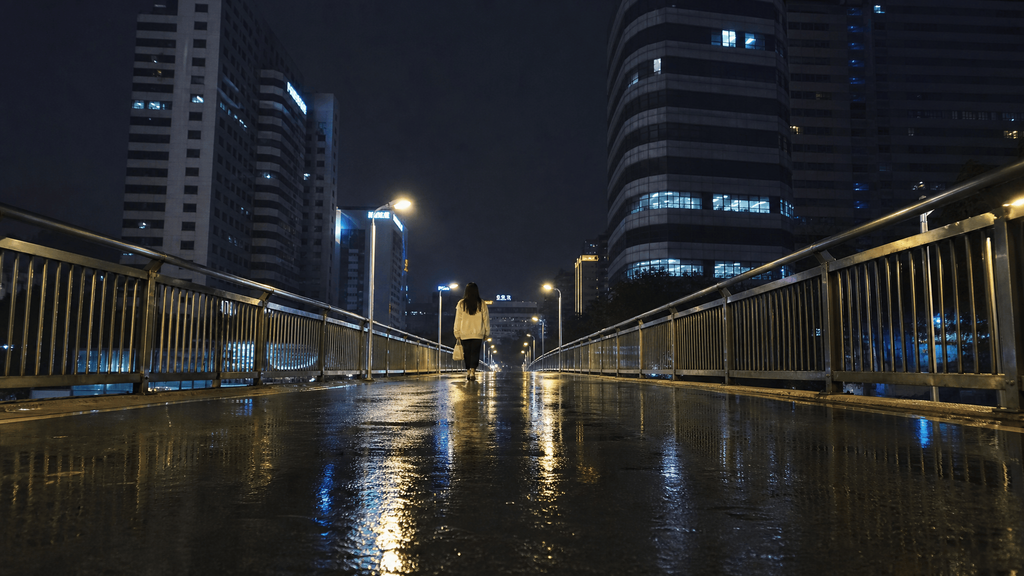
2. 要被隔离、要偷偷看:用长焦把空间压扁
适用:人群里只有她是清楚的、隔着车窗看、下班潮里的一张呆脸、不想让环境说话。
❌ 别这么写:
长焦,广阔天桥全景,环境细节拉满,浅景深,电影感出来通常是:你要全景,又要背景糊成奶油。长焦会把远处拉近,全景需要看清远近。两个目标在抢同一张图。
✅ 让长焦去干它会的事——折叠、隔离、隔一层东西看:
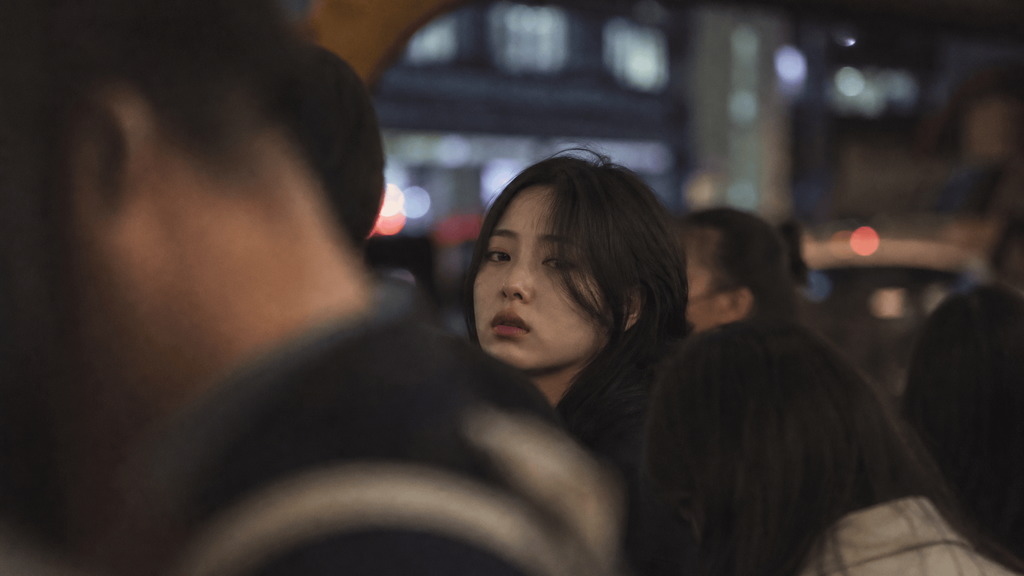
隔着脏玻璃看,也是长焦的活。偷窥感来自距离和遮挡,不是来自「悬疑」两个字:
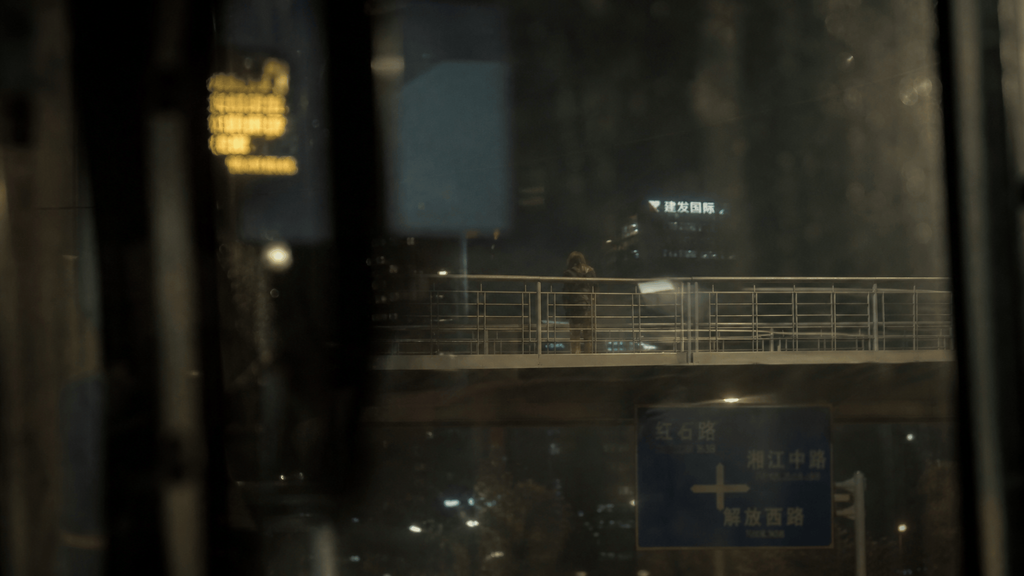
检查三件事:
- 你要的是「拉开」还是「压扁」。两个词写进一句,透视会疯
- 广角有没有在拍脸。要脸,就走近或换长焦,别用拉开空间的镜头怼鼻子
- 「85mm / 电影镜头」后面有没有补上结果。只丢数字,模型不一定知道你要隔离还是要装下整座桥
这就像搬家:你不能既要求客厅显得更大,又要求对面楼贴到窗玻璃上。 拉开和压扁,一次只许做一件。
为什么这招有效: 模型听得懂透视,也听得懂矛盾。你给两套物理,它就缝。 你负责选定一种变形。它负责把桥拉长,或把楼贴过来。
三、词都对、图却假:别让相反的物理叠在一句里
很多图一眼假,不是皮肤不够细,也不是路灯不够亮,是逻辑冲突。 现在的模型很听话:你写什么它画什么。你写互相打架的拍摄条件,它就硬焊。
视觉信息一旦违背常识,大脑会立刻觉得不对劲。高级镜头语言的第一件事,不是炫,是统一。
❌ 新手重灾区,别这么写:
远景,女生站在天桥尽头,极浅景深,广角,背景被拉近压缩,电影感,8k失败拆解:
- 远景通常要让远近都认得出,才能交代这座桥有多长;你却要极浅景深,远处直接化掉
- 广角负责把纵深拉开;「背景压缩」是长焦的活。两个相反的光学现象写在一起
- 结果就是:透视乱、边缘像抠图、虚化生硬,一张假照片
生活里也一样。你站在天桥对街,用手机广角拍过去,整条桥都该清楚。你不可能同时得到「人只有一个点」和「背景像奶油一样糊」。那不是电影,是两台相机抢一个快门。
✅ 先定一个物理目标,再让景别、焦段、虚实、光都为它服务。
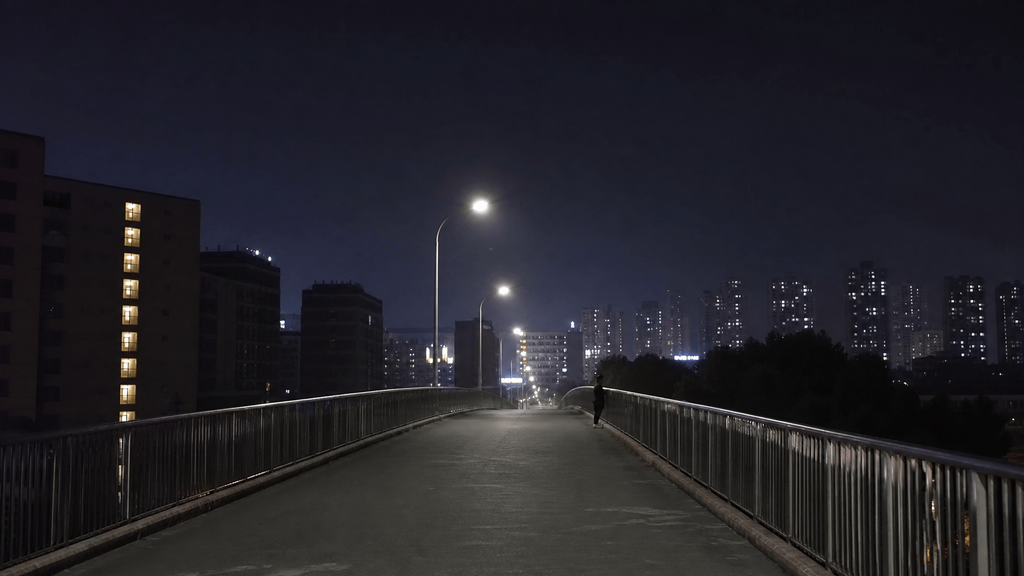
要「被这座桥吞掉」:
要「全世界跟她无关」:
要「就是路过拍到的」:
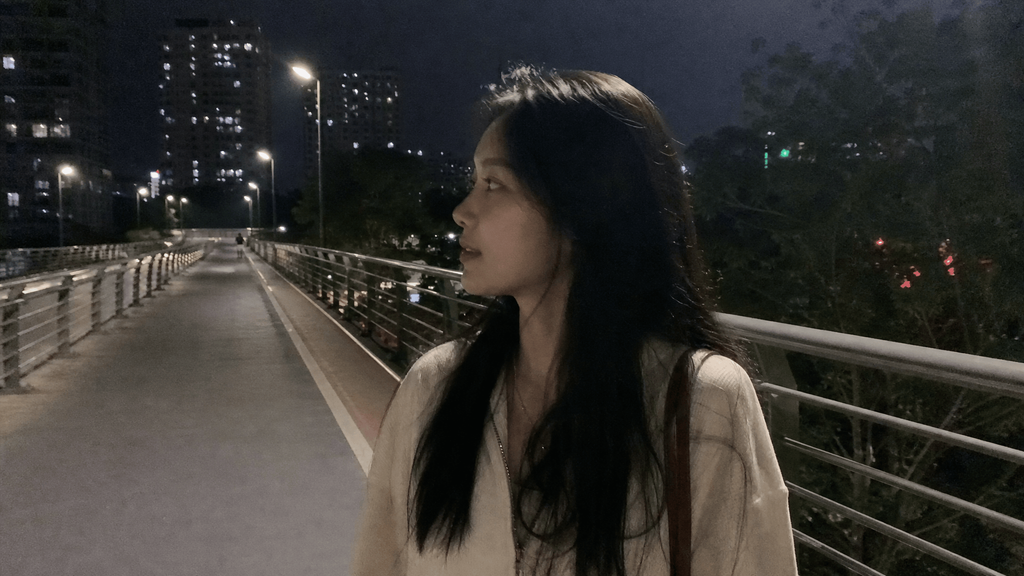
三套可以选,不许混装。 压迫感:中近景加广角畸变,或者长焦压扁加高反差,二选一。 大动态:中景或全景,加广角拉出的近大远小,再加一点路过的糊。 日常:中景,接近人眼,环境留着。
当景别、焦段、景深、光服务于同一套物理时,模型就不再抽盲盒。它变成一台你指定过位置的相机。
检查三件事:
- 远景有没有在要浅景深。要环境说话,就让远处也认得出
- 广角有没有在要背景压缩。拉开和压扁不能同居
- 写之前有没有在脑子里搭片场:相机放哪、装了什么镜头、离她几步。按这个顺序写,画面才会有秩序
这就像做饭:火候、锅、菜,要为同一道菜服务。你不能用炖的火,炒的锅,再要求它是一份沙拉。
总结:镜头不是词库,是站位和物理
画面像摆拍、像缝合、像脸被焊在风景上,先按表查:
| 你卡在哪 | 别急着加 | 先改哪一句 | 你最后只写什么 |
|---|---|---|---|
| 想孤独,结果是夜景证件照 | 别写孤独 / 情绪饱满 | 把「感觉」改成「人有多大」 | 极远景,人只占一小块,看不清脸 |
| 想崩溃,结果像情景喜剧 | 别全程中景还要求情绪爆炸 | 高潮才用特写,前面先远或中 | 先交代她在桥上,再给半张脸 |
| 想压迫,结果鼻子被拉歪 | 别广角贴脸 | 广角去拉空间,脸交给中近景或长焦 | 广角 + 人小 + 地面靠近镜头 |
| 想高级,结果像监控偷拍失败 | 别长焦还要广阔全景 | 长焦负责隔离,不负责装下整座桥 | 长焦 + 脸清楚 + 背景压扁虚掉 |
| 词都对,还是假 | 别再追加电影镜头 / 8k | 检查有没有相反物理 | 远景就深景深;广角就别压缩;一次只站一个位置 |
再记三句:
- 景别是音量。人小,情绪远;脸近,情绪炸。
- 焦段是变形。广角拉开,长焦压扁,一次只做一件。
- 真来自不打架。相机放哪、离人多远、空间怎么变,必须是同一套。
三件可以装进同一段,但不要倒着填。先定观众站哪,再定拉开还是压扁,最后才写谁清楚:
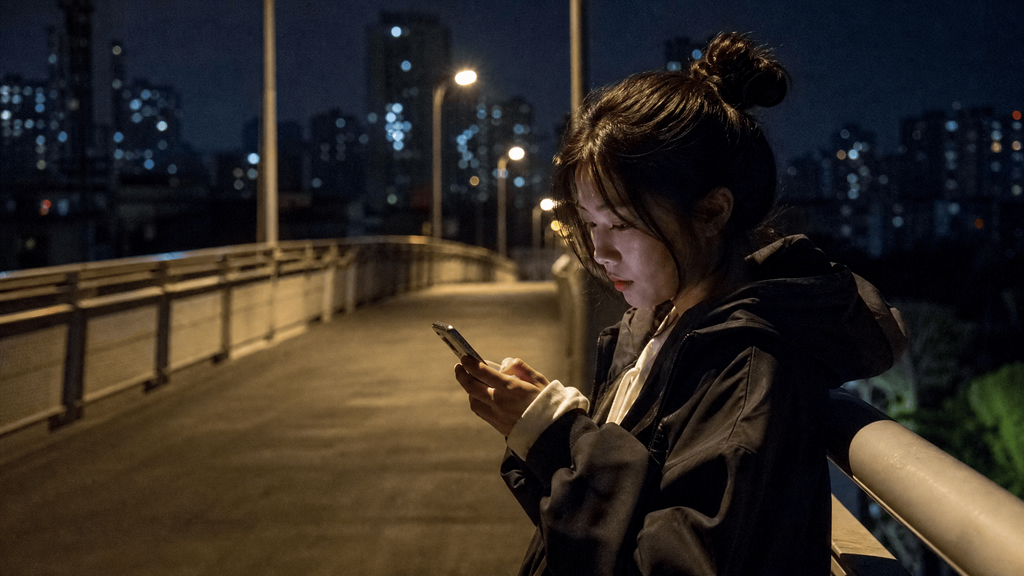
课后只跑通一个题目,不许中途改成别的场景:
- 用开场那句「广角、特写、浅景深、电影镜头」先出一张,留下这张缝合的。
- 只改景别:极远景,人变小。对比那张证件照。
- 只改焦段:同一座桥,一张广角拉开,一张长焦压扁。对比透视。
- 只改逻辑:删掉互相打架的词,让远景配清楚的环境,或让中近景配压扁的背景。对比那张假的。
四步走完,你手里应该是同一座桥、同一个人、被你关掉镜头滤镜词之后才站得住的一张图。 不是四次互不相干的「再加点电影感」。
你不需要先成为镜头词典。 你只需要先成为那个肯问「观众站哪、空间怎么变、这三句有没有打架」的人。

暂无评论内容