
你不是不会写提示词。你是把「心里那团感觉」直接许了个愿,然后怪模型没读懂你的心。
你习惯这么干:
脑子里有画面 → 对着光标憋 → 憋出「氛围感、电影感、高质量」 → 连抽四张都不对 → 再换一组更虚的词
模型收到的不是画面,是评分标签。 你觉得自己在创作。它觉得你在说「给我一张好看的」。
口诀:感觉自己留,问题交给 AI 问,你只负责答、挑、钉。
本节只练三件事:
- 开口难:别自己当导演词典,让语言模型一个问题问下去,你做选择题
- 碎片有了却乱:别把聊天记录直接扔给生图,先按图纸组装
- 第一次不像:别点重新生成,把图拿回去对照——哪块不对、为什么、改成什么
生成前请先打开一个能聊天的模型。没有采访,后面两步没有原料。
开场:你卡的不是英语,是工序反了
试一下这句:
雨夜一个人在厨房,很有生活感,很治愈,电影感,高质量出来的十有八九是:人居中、锅在冒一点白气、灯很亮、脸很干净。 精致,但不是你要的那一晚。
因为你只交付了三个标签:雨夜、厨房、治愈。 没交付模型真正要的东西:
- 人站在画面哪一侧
- 窗外的冷和锅边的热怎么顶
- 这张图是偷拍、广告,还是手机随手拍
- 如果是视频,这 5 秒里到底谁在动
人脑可以靠「治愈」脑补一整场戏。 AI 不会。它听不懂诗,只听得懂能执行的条件。
所以工序要反过来:
别先写提示词。先让一个会问问题的模型,把你脑子里的雾问成能看见的零件。 你负责点头、摇头、选一个。 它负责把零件排成图纸。 生图工具只负责按图纸干活。
下面三步,用同一个场景从头跑完:雨夜进门,煮一碗面。每一步都有普通人翻车对照,以及能直接抄的中文。
一、开口难:别自己想词,让 AI 当问询员 ,你只做选择题
对模型来说,提示词不是文采,是尺寸。 你自己憋「侧逆光、浅景深、胶片颗粒」,等于没量身就自己画裁缝图——画得越专业,越可能不是那件衣服。
改法:不要你去引导生图工具。先找豆包 / ChatGPT / Gemini,让它当你的问询员。 一个问题问完,你再答下一个。你不会写细节,但你看得懂选项。
场景:下班推开出租屋门。外面还在下雨。你想要一张「进门后那两分钟」的图,给日常账号封面用。心里很满:冷、湿、热气、肩膀还没干。手上一个字都没有。
❌ 别一上来就对着即梦硬写:
一个女生在厨房煮面,雨夜,温暖,治愈,生活感,8k「温暖」对它约等于开灯。「生活感」约等于桌上多放两样东西。 跟你那件还没干的外套、那口还没滚的锅,不是一回事。
先把这段丢给聊天模型,启动采访。可直接复制:
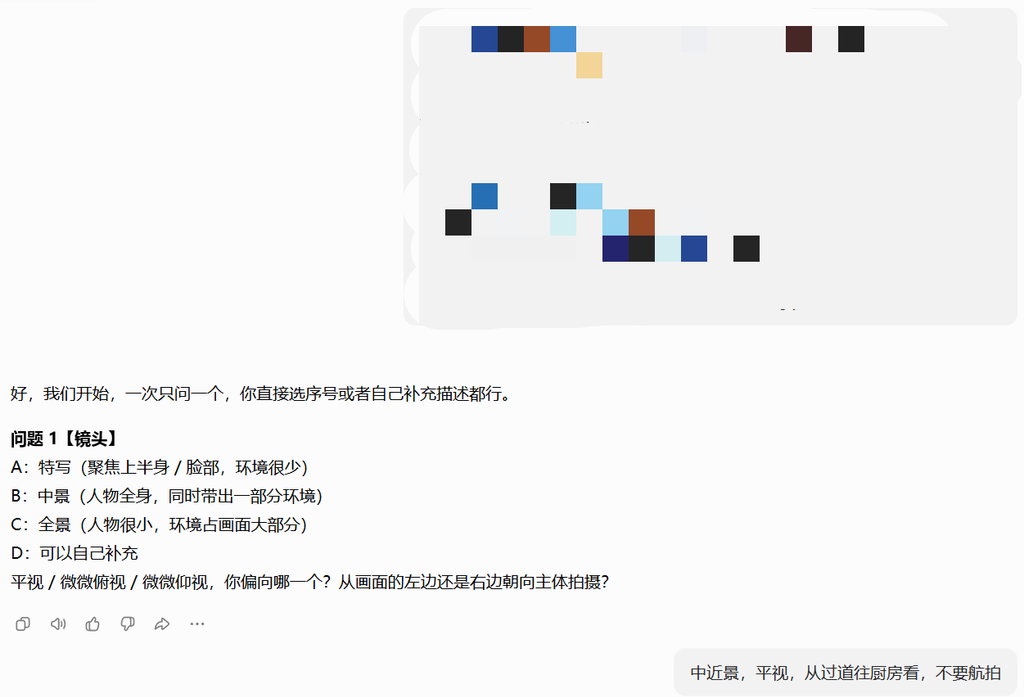
你只要答人话。下面是一次完整示范,你可以照着选,也可以换成自己的:
| 它问什么 | 你怎么答(本课案例) |
|---|---|
| 这张图给你什么感觉 | 外面又冷又湿,屋里只有灶台这一小块是热的 |
| 镜头多近、从哪看 | 中近景,平视,从过道往厨房看,不要航拍 |
| 人放哪、留给谁 | 人偏右,左边留给窗户上的雨和水汽 |
| 主体在干什么 | 一个人穿着还没干的外套,低头看锅,不看镜头 |
| 光怎么来 | 头顶一盏暖黄小灯;窗外是冷的蓝,雨还在下 |
| 像什么拍出来的 | 手机随手拍,轻微噪点,不要广告,不要明星脸 |
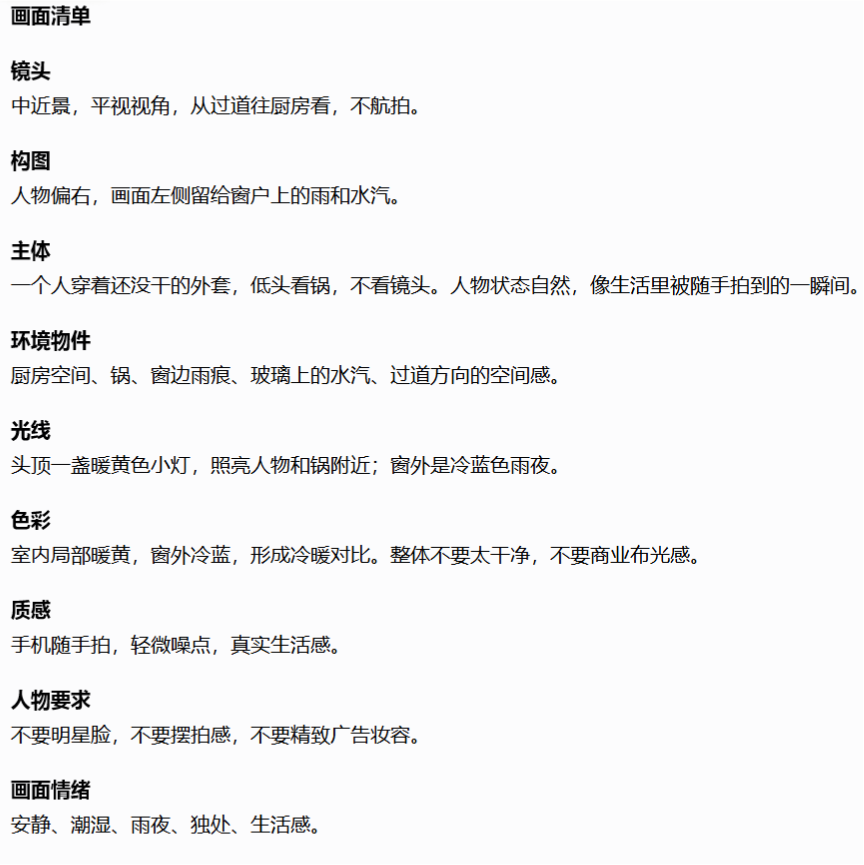
答完,它应该吐给你一张清单,而不是一篇「雨夜的诗」。 清单长这样才算合格:
- 过道看进厨房,中近景,平视
- 人在右侧三分,左侧是窗和雨
- 外套下摆还挂着水,锅里有热气
- 暖黄顶灯 vs 窗外冷蓝
- 手机抓拍,不是海报
检查三件事:
- 它是不是一次只问一个问题。五个问题一起砸过来,你会重新空白
- 你答的是不是选择题,而不是又开始憋专业词
- 清单里有没有「电影感 / 高质量 / 治愈」——有,就让它删掉重出清单
这就像去裁缝店:师傅问你肩宽、袖长、面料,你不用自己画图。 你负责说「紧一点、不要垫肩」。图纸是他的事。
为什么这招有效: 细节很难凭空捏。可是「中近景还是远景」「人靠左还是靠右」,你看一眼就知道。 采访把「翻译」从你脑子里搬走了。你只做判断,不做词典。
二、碎片有了:别直接扔给生图,先按图纸组装
采访结束,你手里是一堆对的零件。 很多人下一步是:把聊天记录全选,粘进即梦。
这等于把量衣的对话录音,直接发给车间。 车间听得懂「右侧三分、暖黄顶灯」,听不懂一段东一句西一句的问答。
改法:先整理,再生图。 图和视频用两张不同的图纸。图管空间关系,视频管谁在动。 先出图,再拿这张图去图生视频。别一上来就让视频模型同时猜场景和动作。
2.1 出图:只组装「这一眼能看见的空间」
静态图的核心不是故事,是站位。谁在前,谁在后,光从哪边来。
图的组装顺序(按这个填,不要倒):
人在干什么 + 这个房间长什么样 + 从哪看、谁占画面 + 光和颜色怎么顶 + 像用什么拍的
把上一节的清单填进去。不要加新灵感。采访里没出现过的绿植、猫咪、唱片机,这一步一律不许进。
❌ 别把问答原样扔进去:
感觉是冷和热,镜头中近景,构图框什么的,主体是小孩还是女生来着,光要自然,风格胶片……
模型会抓住它最熟的那几个词,其余当没看见。
✅ 按图纸填完,可直接跑:
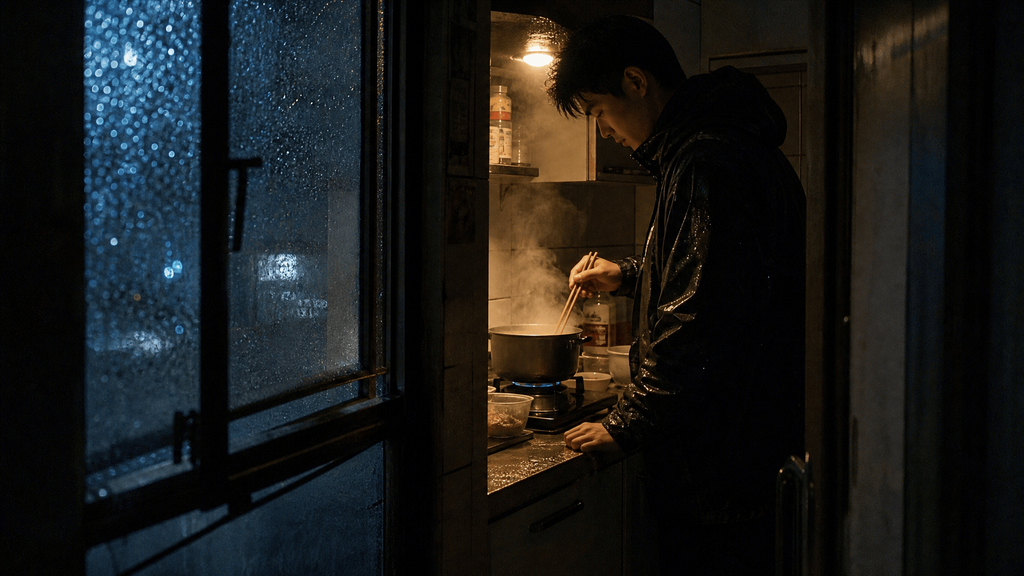
检查三件事:
- 五个格子是不是都有着落:人、房间、站位、光、拍法
- 有没有混进采访时没选过的道具
- 「治愈 / 电影感」是不是已经删干净——这些词会把图纸重新搅成许愿
这就像把量体记录抄成一张裁剪单:胸围、衣长、扣子位置,各写各的。 不是把你和师傅的闲聊打印出来当图纸。
2.2 出视频:图已经有了,文字只写「这 5 秒谁在动」
图对了,再进MetaDig/即梦 做 5 秒。 很多人这里会把出图那一大段再贴一遍,再加「镜头推进、热气升腾、很有感觉」。
视频模型听完,往往开始加戏:人转身、微笑、端碗、看镜头。 空间是对的,动作却像演生活广告。
视频图纸跟图不一样。图问「在哪」。视频问「谁动、怎么动、环境跟不跟」。
视频的组装顺序:
人只做一件具体的事 + 镜头怎么慢慢走 + 锅气 / 雨 / 灯光跟着怎么动 + 这 5 秒里情绪不要升级
❌ 主体动作别写成事件名:
她在煮面。
「煮面」是流程。模型会随机抽一个煮面瞬间:搅拌、加葱、端碗,每一版都不一样,也都不像你要的那两分钟。
✅ 锁死一个微动作,可直接跑:
拆开看这张视频图纸:
| 格子 | 本课怎么填 | 别填成 |
|---|---|---|
| 人怎么动 | 挑起一缕面,停一下看熟了没 | 煮面、做饭、忙碌 |
| 镜头怎么动 | 从过道极慢往前挪一点 | 环绕、快推、变焦炫技 |
| 环境怎么动 | 热气贴筷子、雨水滑玻璃 | 「氛围流动」「空气在呼吸」 |
| 什么不许动 | 不转身、不笑、不换房间 | 什么都允许,让模型自由发挥 |
检查三件事:
- 人是不是只有一个动作。出现第二个动词,先删
- 出图提示词是不是没有整段贴回来——图已经在,视频只补运动
- 5 秒够不够走完「挑起来、看一眼」。不够就别加「然后关火、然后坐下」
图是布景照。视频是让布景里的一件事发生。 布景已经有了,就不要让演员把整晚的生活再演一遍。
三、第一次不像:别点重来,把图拿回去对照着改
图纸跑完,图还是可能偏。 偏了最常见的反应是:「这什么东西,重抽。」
重抽是在买下一张随机数。 你上一张里已经对的站位、已经对的窗,会一起被扔掉。 更糟的是:你不知道它错在哪,于是下一句提示词只能写「再自然一点」「再生活感一点」——许愿升级。
改法:把生成结果丢回给刚才那个问询员。不许它写安慰,只许它跟你做三道题。
对照三问:
- 哪一块不对? 说位置,不说评分。
- 为什么会这样? 说提示词里哪一句把它带跑了。
- 下一句改成什么? 只改这一块,其余照旧。
可直接复制:
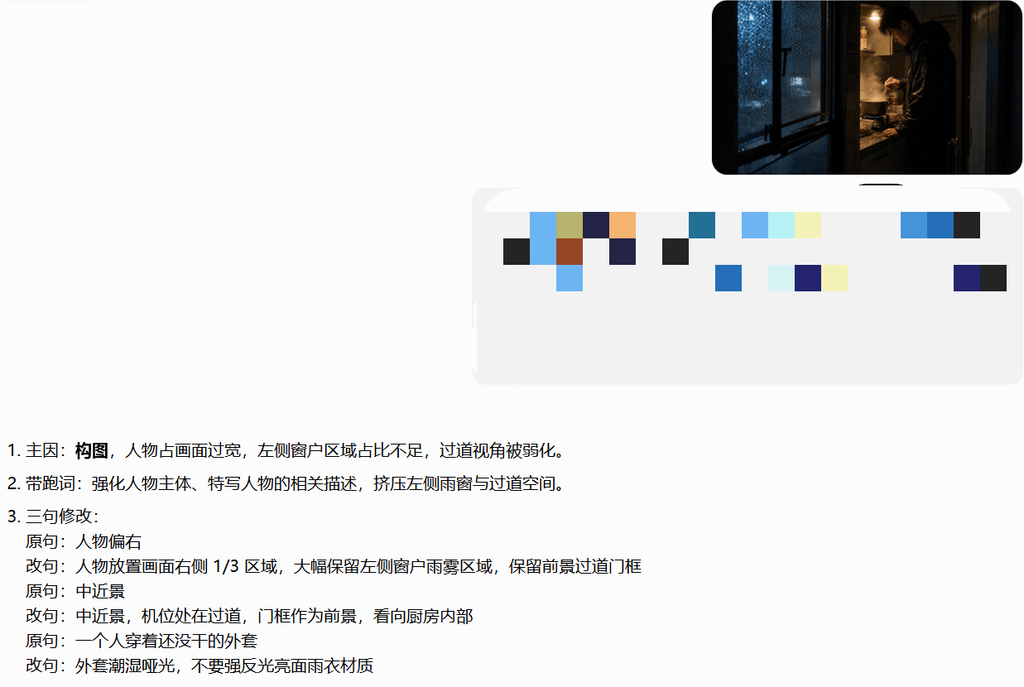
最常见的一种偏:东西都对,但看起来像杂货铺
场景换一个,方便你看清「对照」和「重抽」的差别。
你想要「周末上午,阳台小桌,一个人喝咖啡看手机」。
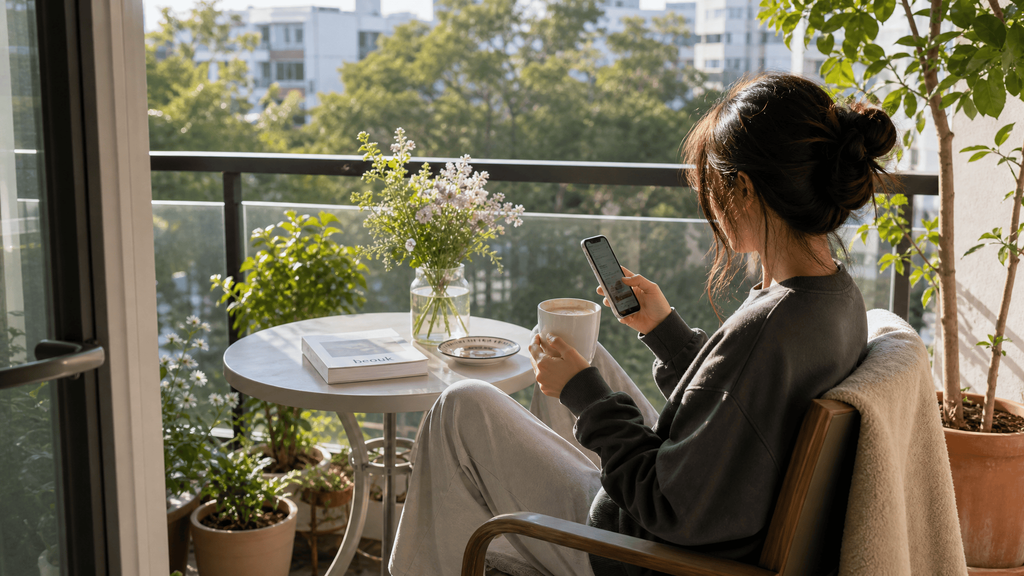
结果:每样东西材质都很好。整张图却没有可以停留的点。眼睛在植物、猫、面包之间跳,像进了二手市场。
❌ 别这么改:
太乱了,整洁一点,高级感
「整洁」可能把生活痕迹全清掉,变成样板房。温热没了,空也没了。
✅ 走完三问,再改:
- 哪一块不对: 没有主角。阳台、桌子、猫、植物同时在抢。
- 为什么: 名词堆太多,模型按「像生活」把每样都画清楚了,没有前后。
- 改成什么: 只留一个主角(小桌 + 那杯咖啡)。猫、衣服、植物退到后面,虚掉。桌面不要再加第三样食物。
图生图可直接跑:
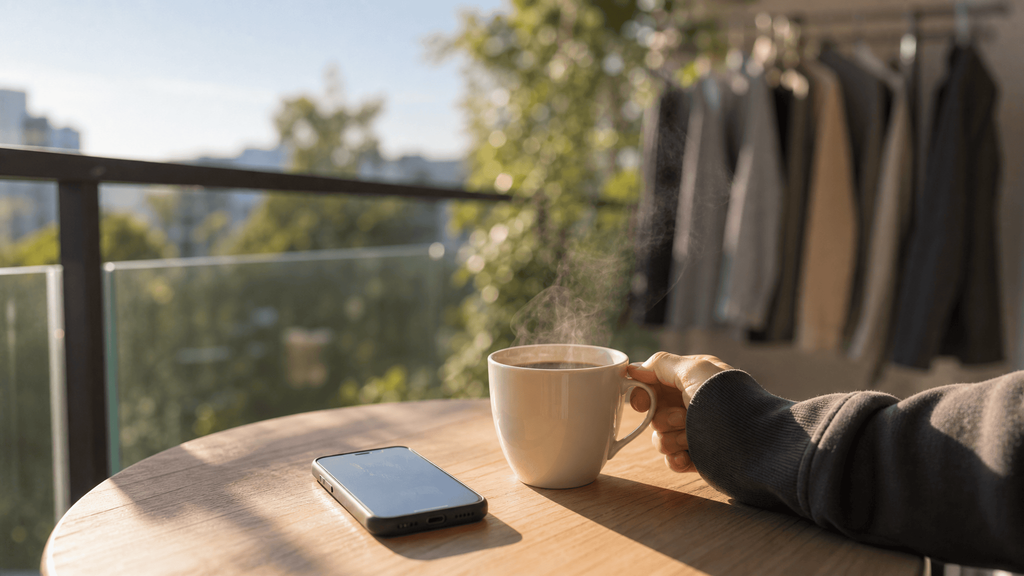
瞬间从「什么都有」变成「先看见这杯咖啡」。 生活感还在,只是排了队:先看谁,后看谁。
检查三件事:
- 你有没有指出「哪一块」,而不是只说「不好看」
- 下一版是不是只动这一块。光对了就别再写光
- 做减法时,减的是不是抢戏的名词,而不是把房间清空
2026 年的模型,加法已经溢出。它很会往画面里塞东西。 你要练的不是再教它加,是拦住它,让一件事当主角。
这就像改稿:编辑不会因为第二段空了把全文扔进碎纸机。 他圈出那一段,写「主语不清,删两个例子」。你照着改。
总结:一对光标就空白,先别抽卡
提示词写不出来、出图不对味、一不对就重抽,先按表查:
| 你卡在哪 | 别急着做 | 先让聊天模型干什么 | 你最后只做什么 |
|---|---|---|---|
| 光标闪,一个细节都写不出 | 别对着即梦许愿 | 按镜头 / 构图 / 主体 / 光 / 风格,一次问一个 | 做选择题,收下清单 |
| 清单有了,图却东一块西一块 | 别把聊天记录整段粘贴 | 按「人+房间+站位+光+拍法」重抄一遍 | 没采访过的道具一律不进 |
| 图还能看,视频开始演广告 | 别把出图长文再贴一遍 | 只写一个微动作 + 镜头怎么挪 + 热气/雨怎么动 | |
| 第一次不像,或东西多到没重点 | 别点重新生成 | 三问:哪块不对、为什么、改哪三句 | 只改这一块;会抢戏的名词做减法 |
再记三句:
- 提示词不是许愿。先让人问你,你再答。
- 零件不等于图纸。图按空间装,视频按运动装。
- 不对就对照,不要整张作废。指出位置,改三句,比抽十张更像创作。
课后只跑通一个题目,不许中途改成别的场景:
- 打开豆包 / ChatGPT / Gemini,用第一节的采访指令,把「雨夜回家煮面」问完,拿到清单。
- 按图的五格抄成一段提示词,出一张。不要在这一步做视频。
- 用这张图生 5 秒,人只挑起一缕面。
- 如果乱、如果太广告、如果人看镜头了,把图丢回去走三问,只改三句再出一张。
四步走完,你手里应该是同一间厨房、同一盏灯、被问清楚再被改过的一张图。 不是四次互不相干的「再试试」。
你不需要先成为提示词词典。 你只需要先成为那个愿意被提问、会把零件抄成图纸的人。

暂无评论内容