
你是不是也经历过这种崩溃:
花了半小时调出一张超满意的角色图,丢进可灵、即梦之类的视频工具,第一秒还行,第三秒鼻子歪了,第五秒发型换了,第七秒直接变成另一个人。
很多人第一反应是:「是不是我提示词写得不够细?」然后继续加形容词、继续重抽、继续烧积分。
先说结论:不是提示词不够细,是你让模型一次干了太多活。
这篇教程不讲玄学,不堆术语。我会用一个新手也能跟着做的完整案例——给一个独立咖啡品牌拍15秒角色短片——把「人物不崩」拆成三件你马上能上手的事。
看完你能直接照做,而不是「听懂了但还是不会」。
先看懂:模型为什么会“忘人”
把视频模型想成一个很会画画、但记性一般的实习生。
你给他一张人物照片,再口头说:「让她在雨夜里跑进咖啡店。」
他要同时想清楚三件事:
- 这个人长什么样
- 咖啡店和雨夜长什么样
- 跑步时手脚怎么动、衣服怎么抖
这三件事每一帧都在变。他一忙就顾此失彼——通常最先牺牲的就是「这个人到底是谁」。
所以真正有效的思路只有一句:
一次只让AI解决一个问题。
下面三个方法,分别管三件事:人是谁、画面怎么定、时间怎么切。
案例设定(后面步骤都围着它)
- 片子: 15秒小红书/抖音广告
- 角色: 25岁女主理人「林夏」——短发、米色围裙、腕上有一枚铜色手环
- 故事线: 清晨到店 → 擦玻璃 → 拉下一杯浓缩 → 对镜头微笑
- 你要用到的能力: 出图工具(MetaDig/Midjourney / 即梦等)+ 视频工具(MetaDig / 即梦视频 / Runway等)+ 任意剪辑软件(剪映就够)
别急着一口气生成15秒。我们按「先锁人 → 再定画面 → 再切时间」来。
方法一:先把“这个人是谁”做成可复用资产
新手最常犯的错
提示词写成这样:
清晨咖啡店里,短发女孩穿着米色围裙在擦玻璃,窗外有阳光,氛围温馨……
看起来很完整,其实是灾难。因为人物、场景、动作绑死在同一张图里。后面一换场景,模型会把人物当背景的一部分一起重画,脸就漂了。
正确做法:先做人,不做事
第1步:出一张「角色设定图」,不是海报
目标不是好看,是把人看清楚。
你可以先生成一张正面全身立绘,再专门做三视图。提示词可以直接用中文(MetaDig 、即梦等都吃得下):
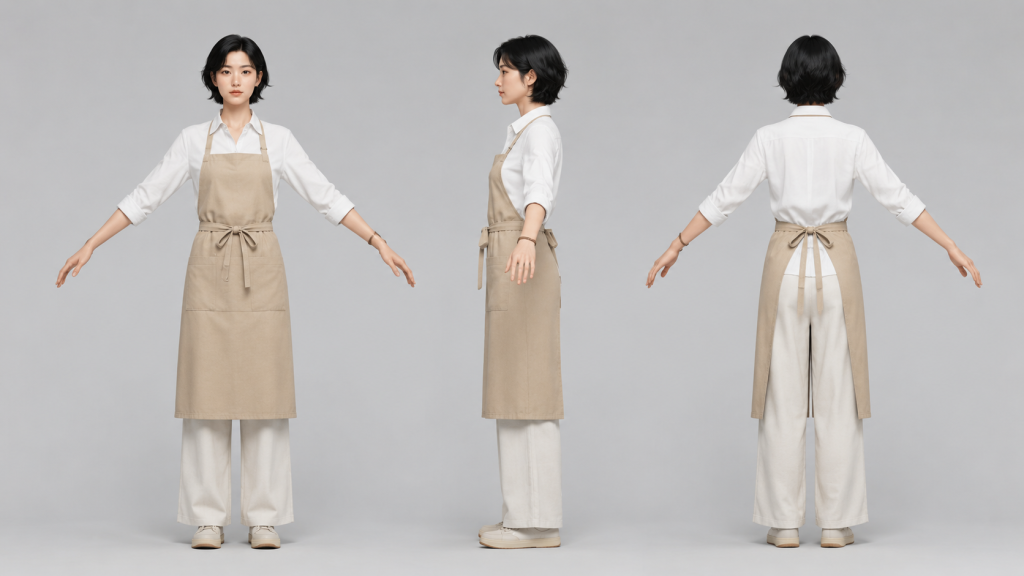
你要检查的点(比“美不美”重要):
- 正面、侧面、背面衣服细节是否一致
- 手环在不在同一只手腕
- 发型左右是否对得上
- 脸型有没有“每一张都换一个人”
不过关就重出设定图,别急着进视频。这一步省下的积分,后面能还你十倍。
第2步:把多视角喂给“角色/主体”功能
现在主流视频工具大多有「主体 / 角色 / 角色参考」一类功能。关键点不是再传一张美图,而是:
把正面、侧面、背面一起上传,创建一个可反复调用的角色。
你得到的不是“某张图”,而是这个项目里的一个「角色卡」。后面无论她在店里、街上还是厨房,都尽量调用同一张角色卡。
实战口诀:先锁定身份,再谈表演。
做到这里,你已经比「一张美图直接图生视频」稳了一个数量级。
方法二:先定死画面 ,再让视频只负责“动起来”
为什么直接文生视频容易崩
如果你直接输入:
林夏在拥挤的早高峰咖啡店里快速穿梭做咖啡
模型要在几秒内同时算:脸、店内光影、肢体动作、人群。三个变量一起抖,人物最容易先碎。
专业一点的做法是反过来:
视频工具不要负责“设计画面”,只负责“让已定好的画面动起来”。
按三步走(跟着案例做)
第1步:白底出「动作静帧」
还是用你的角色卡,但背景写成纯白/浅灰。只关心姿势对不对。
例如「拉开咖啡机把手」这一下:
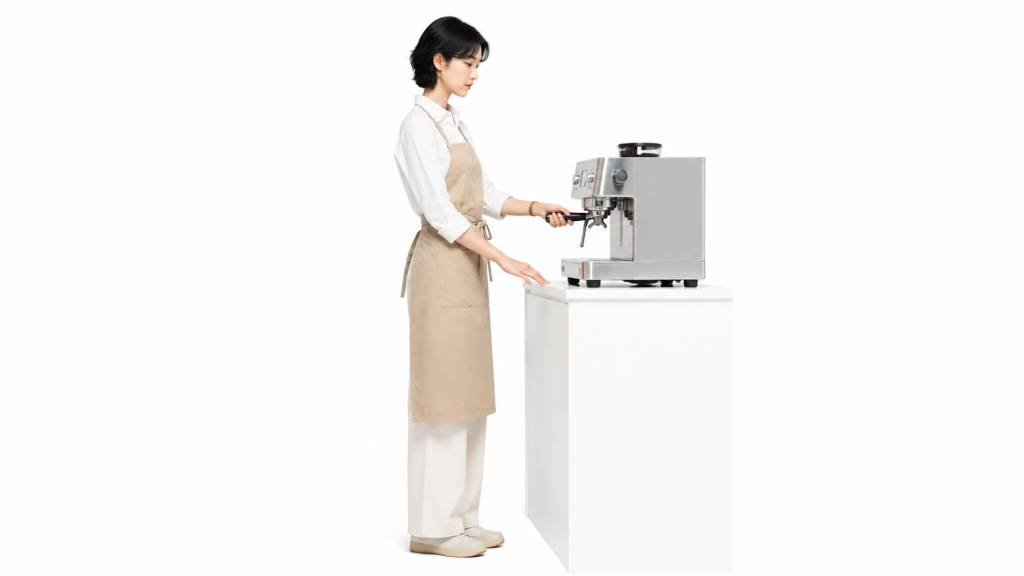
这一步只问三句话:
- 是不是同一个人?
- 动作骨架对不对?
- 围裙和手环还在不在?
第2步:把人贴进场景,先合成「完美静止帧」
准备一张空镜:清晨咖啡店吧台、暖光、窗外街道虚化。空镜提示词可以这样写:
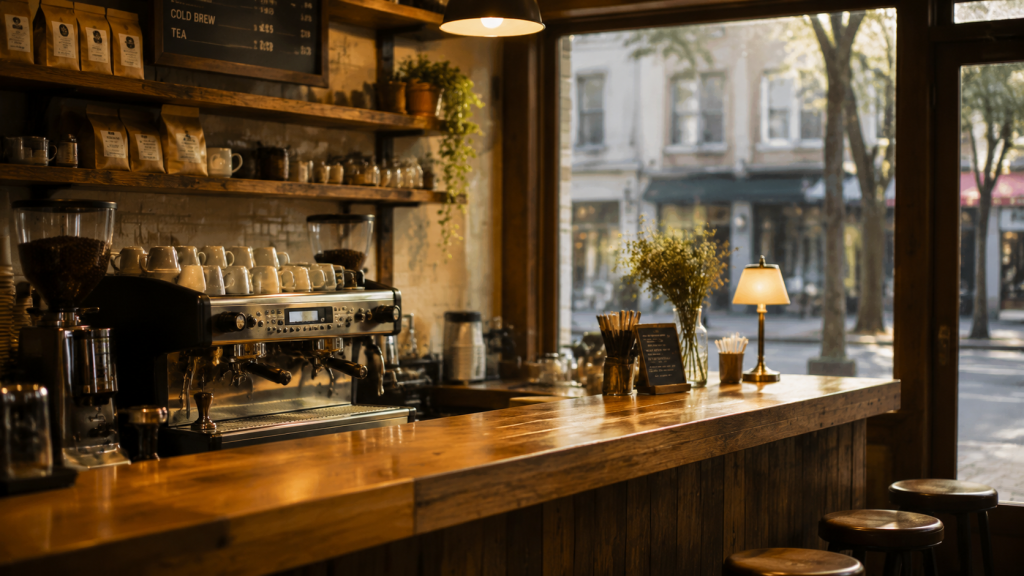
把白底人物抠出来放进去,用你习惯的修图/AI合成工具统一光影方向(人物受光要和店里灯光一致)。
这一步你可以做出两张:
- 起始帧: 手刚搭上咖啡机
- 结束帧: 把手拉到位,蒸汽微微起来
两张都必须是「同一个人 + 同一套衣服 + 同一家店」。
如果工具支持「参考角色 + 场景描述」直接出合成静帧,也可以这样写(记得挂上角色卡):
第3步:图生视频——只给位移,不给想象
把起始帧、结束帧丢进视频工具。提示词只写动作即可,例如:
动作流畅,双手平稳下拉咖啡机把手,杯口冒出少量蒸汽,
镜头固定不动,人物五官、发型、围裙和手环保持不变
这时候模型的任务变简单了:它不用猜她穿什么、店里长什么样,只要算像素怎么移动。
你会明显感觉:同样积分,成功率突然高了。不是模型变聪明了,是你把难题拆开了。
方法三:别拍“一镜到底”,把15秒切成小块
时间越长,人物越容易慢慢“漂移”
扩散类视频模型大致是在猜下一帧。猜得越久,误差越容易叠起来:第1秒还像,第4秒眼神漂,第8秒脸就换了。
所以新手最伤的执念是:我要一次生成完整15秒大长镜头。
别这么干。
把故事切成「原子镜头」
还是那个咖啡短片,建议切成这样:
| 镜头 | 时长 | 只做什么 | 景别 |
|---|---|---|---|
| A | 2–3秒 | 推门进店,背影 | 全景 |
| B | 2–3秒 | 擦玻璃,侧脸 | 中景 |
| C | 2–3秒 | 拉浓缩,手部+半身 | 中近景 |
| D | 2–3秒 | 对镜头微笑 | 近景 |
原则就一条:
一个片段只承载一个核心动作。
四个镜头的视频提示词,可以分别写成(都挂同一角色卡):
每个片段尽量落在工具比较稳的区间(常见经验是大约2–4秒)。短了好控,长了才容易崩。
用剪辑把“稳”变成“好看”
四个短镜头在剪映里接起来,加一点转场音效和咖啡机声音,观感往往比一条晃荡的长镜头更像广告。
这不是偷懒,这是把AI当成摄影组:你是导演,负责分镜;模型是执行,负责单镜头表演。
一张表带走:今天就能用的作业流程
按顺序做,不要跳步:
- 锁人: 三视图设定图 → 创建角色/主体
- 定画: 白底动作静帧 → 合成到场景 → 得到首尾帧
- 驱动: 图生视频,提示词只写运动
- 切时间: 2–4秒原子镜头 × 若干条 → 剪辑成片
- 验收标准:
- 换场景后脸还像不像?
- 手环、围裙有没有丢?
- 单镜头里有没有突然换发型?
如果某一环崩了,回到对应那一层修,而不是整条片子重抽。
结尾:你不是在“抽卡”,你是在“控场”
回头看,三个方法其实在做同一件事:
- 拆身份: 先固定“谁在演”
- 拆空间: 先固定“在哪演、站什么姿势”
- 拆时间: 先固定“一次只演多长”
AI很强,但它不会自动替你当导演。你给的约束越清楚,它越像在执行拍摄;你给的约束越含糊,它就越像在抽奖。
今晚就用「林夏咖啡店」这个小题目跑一遍。不用追求大片,先追求一件事:
从第1秒到第15秒,她还是同一个人。
做到这一点,你就已经跨过了AIGC视频最劝退的那道门槛。

暂无评论内容