
很多新手看到一条很炸的 AI 视频,第一反应几乎一样:
暂停 → 截一张最帅的画面 → 丢给多模态大模型 → 问「这是什么?帮我写视频提示词」→ 复制粘贴去生成。
出来的片子常常是:
人物对得上,色调也像,物件差不多齐。 可一动起来,完全不是那回事。
原片里冲过来的压迫感没了,镜头往前拱的劲没了,光影扫过去的节奏也没了。 你得到的是一张「会轻微扭动的海报」,不是一条有力气的视频。
这时候你会下意识再加词:
电影运镜、动态模糊、史诗感、紧张氛围、超流畅
画面可能更花了,假的感觉通常还在。
更大概率不是模型复刻不了,而是你从第一步就问错了问题。
你问的是:这张图长什么样? 原片真正值钱的是:从这一秒到下一秒,什么东西在怎么变?
一张截图,像考试只给了最后答案,没给解题步骤。 AI 很会照着答案再画一张像的;但它看不见中间那几秒的位移、推近、扫光、减速。
今天不堆虚词。下面三步,专门解决「风格抄到了,动感抄不走」。
第一章:反推「变化过程 」,不是「画面内容」
1.1 为什么一张截图会失败
在多模态模型眼里,一张静图只是某个瞬间的切片。它看得见物体、颜色、构图,看不见下一秒会发生什么。
所以你把截图扔过去,本质上是在说:「给我一个长得像这样的东西。」 AI 很听话,它画了。 然后你再说:「让它动起来。」 因为没有变化证据,它只能瞎猜——云往左,或者树往右。通顺,但不等于原片。
根因就一句:
你丢失了时间维度的信息。
1.2 正确做法:截三帧,只问「怎么变的」
要反推一段视频,不能只看「最好看的一张脸」,要看一段变化。
至少截三个节点:
开始前 :动作还没爆发,画面相对稳最猛时 :位移最大、光影最狠、压迫感最强结束后 :尘埃落定,或主体已经贴脸 / 离开画面
像复盘打架录像:不能只截一拳打中的瞬间,还要有抬手前和打完后。
公式:
实战案例:夜市小吃车冲向镜头
普通人只会截「车头已经很大、很帅」的那一张,然后问:
这是什么?请写成视频提示词,要有冲击力常见翻车:车在动,但像原地抖的大特写,没有「从远到近把空间吃掉」的过程。
正确截帧:
- 开始:车在巷子尽头,很小,灯牌只是两点光
- 高潮:车头已经很大,横向甩一下,蒸汽开始糊边
- 结束:金属细节和热气几乎贴脸,远处背景被挤出画面
识图时这样问:
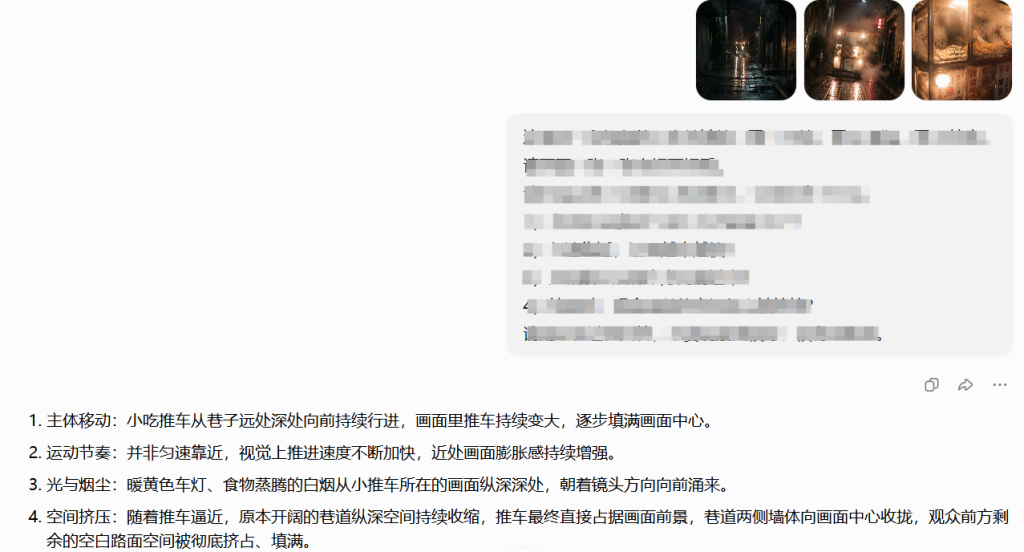
你该拿到的,不是「赛博夜市,冲击力拉满」,而是能直接拿去生成的过程句:
夜市窄巷,远处一辆亮着灯牌的小吃车从小变大,一路加速冲向镜头
中段车身明显往旁边甩了一下,蒸汽和灯牌光开始糊住画面边缘
结尾车头几乎贴脸,金属细节和热气占满画面,远处背景被挤出去
不要原地抖动的大特写,不要只变模糊不变近
三帧不是为了让 AI 看得更清楚,是为了逼它看见时间。
第二章:用「镜头怎么走 」来反推指令
2.1 别让 AI 写散文
很多人第二步会问:
这个视频用了什么提示词?请完整还原模型很愿意给你一段高级散文:
极具张力的夜景,光影交错,充满速度感与命运感,
镜头如猎豹般锁定目标,气氛压抑又迷人……
读起来很帅,拿去生成经常还是软的。 这些词在夸观感,没有在下调度指令。 视频模型更吃得懂的是:镜头往哪移、移多快、是身体在挪还是焦距在变。
你要反推的,是导演现场会喊的话,不是影评。
2.2 问清「推进」还是「变焦」
把问题改成摄像机考卷,至少问清:
- 镜头是真的往前走,还是原地放大?
- 有没有升高、降低、左右横移?
- 前后景有没有错开?(有,多半是真推近;没有,更像变焦)
- 画面边缘有没有越来越拉伸?
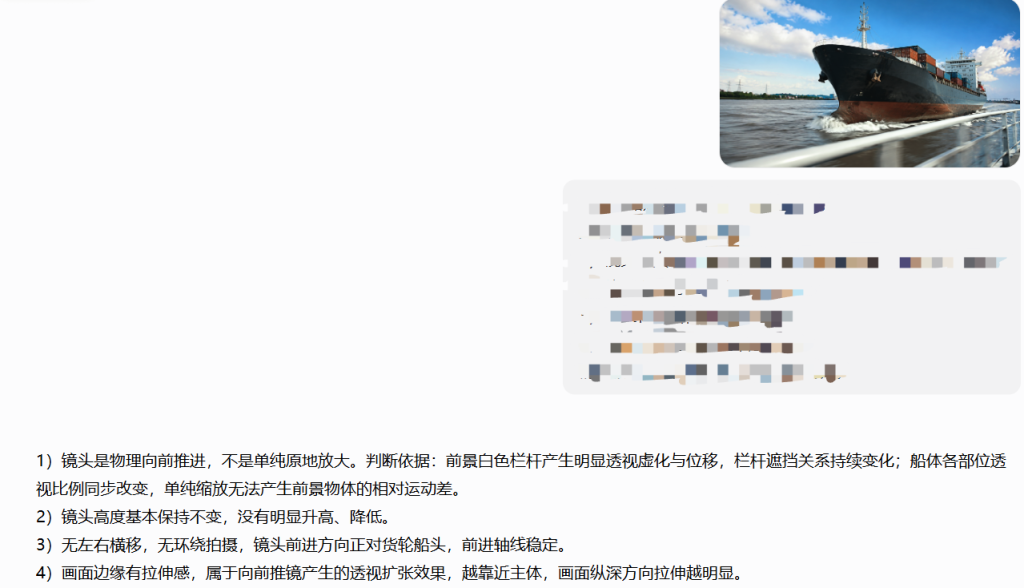
实战案例:江边货运船冲到船头特写
模型如果答得对,大概会接近这种信息:
镜头是真的往前飞近船头,不是原地放大
同时镜头慢慢抬高,从低角度大远景过渡到高角度近景
近处栏杆跑得很快,远处江岸相对更慢,前后景一直在错开
你再收成生成提示词:
江边货运船,镜头从远处低角度快速向前靠近船头,边推近边向上抬
从大远景过渡到高角度近景,广角,船身越来越大
近处栏杆掠得很快,远处江岸移动更慢,前后景明显错开
强调速度和体量,不要原地放大假推进,不要PPT缩放感
为什么非要分清推进和变焦?
- 真推进:近处跑得快,远处相对慢,空间有厚度
- 假变焦:整个画面像电子放大,容易发平,像 PPT 缩放
一词之差,常常就是大片感和动画感的差别。
第三章:把分析翻译成能执行的中文指令
3.1 别直接把分析原文贴回去
很多人前两步都做对了,最后栽在这里。
模型分析得挺好:
镜头像一只贴着浪尖掠过的鸟,带着危险又自由的气息,
迅速掠过金属表面,仿佛随时会被卷进风暴……
整段复制丢进视频模型,它可能只听懂:鸟、浪、金属、风暴。 然后给你一个「有点像,但调度很糊」的东西。
问题不是分析废了,是你把解说词当成了操作手册。
3.2 删空话,留下「谁在怎么动」
翻译原则就四条:
- 删情绪词、评价词、比喻词
- 留主体、动作、镜头、速度、光影变化
- 能写短句就别写散文
- 最后补一句「不要什么」
对照一下:
| 模型常说的空话 | 翻译成可执行中文 |
|---|---|
| 镜头浏览整个场景 | |
| 张力很强,动作很剧烈 | |
| 像被吸入画面中心 | |
| 光影如梦似幻 |
实战案例:雨夜机车冲进霓虹主街
不要这样写:
一个很酷的雨夜机车,飞得很快,霓虹很炫,电影感拉满要写成这种:
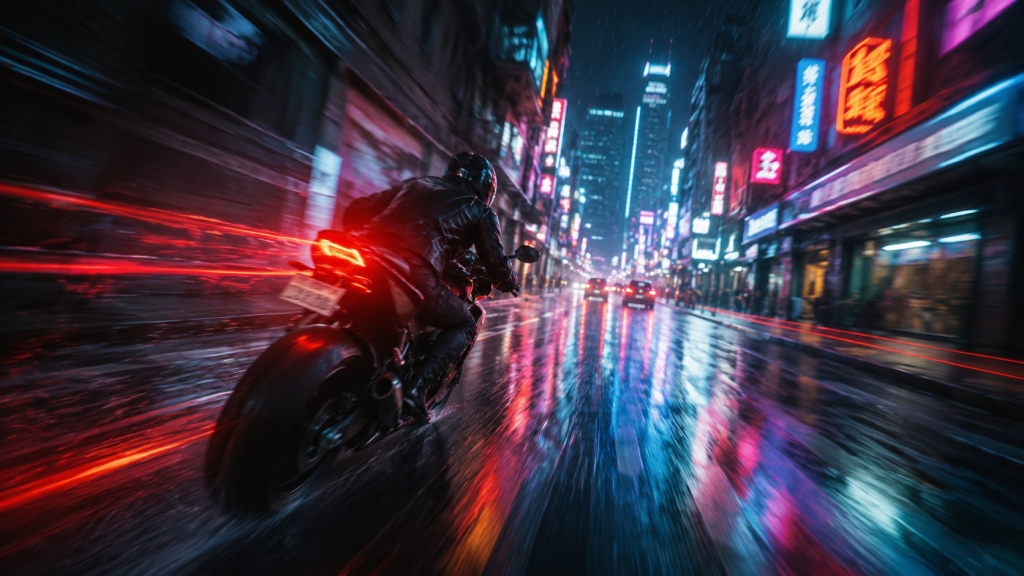
分析可以感性;生成指令必须克制。 中间少了你这道翻译,复刻成功率会断崖。
结语:复刻的不是画面,是「怎么变过来的」
所谓视频复刻,本质上不是抄一张好看的静图,而是把变化过程问清楚、写清楚。
- 第一章:一张截图天生缺时间,三帧才有变化证据
- 第二章:散文提示词像影评,镜头路径才像导演指令
- 第三章:模型的分析可以浪漫,生成指令必须冷静可执行
你不需要先成为运镜专家。从今天起,把最近一条「长得像、动起来不像」的视频找出来:
先改一步:一张截图,换成开始 / 高潮 / 结束三帧。 再改一步:「给我提示词」,换成「只分析镜头怎么动」。 最后补一步:删掉震撼、史诗、氛围,留下主体、动作、镜头、禁令。
改完这三步,复刻通常才会开始像在还原一场运动,而不是在给海报做特效。

暂无评论内容